
外观
为什么需要上下文工程?
上下文工程是构建可靠、高效 AI 智能体的重要实践。本指南通过构建深度研究智能体的案例,解释上下文工程的价值。
上下文工程需要仔细设计并改进提示词、指令和约束,引导智能体的行为,使其实现预期结果。
原文课程信息
本文基于《使用 n8n 构建有效的 AI 智能体》,课程提供智能体系统的设计与实现方法、可下载模板、提示词和进阶技巧。
什么是上下文工程?
上下文工程是设计、测试和迭代提供给智能体的上下文信息,以塑造其行为并改善任务表现的过程。针对智能体的上下文工程不同于只面向单次模型调用的简单提示工程,它包括但不限于:
- 系统提示词:定义智能体的行为和能力。
- 任务约束:指导决策。
- 工具描述:明确可用函数或工具的使用时机与方法。
- 记忆管理:在多个步骤之间跟踪状态。
- 错误处理模式:保障执行的稳健性。
案例:构建深度研究智能体
下面通过一个能够搜索网页并生成报告的最小深度研究智能体,说明上下文工程的基本原则。
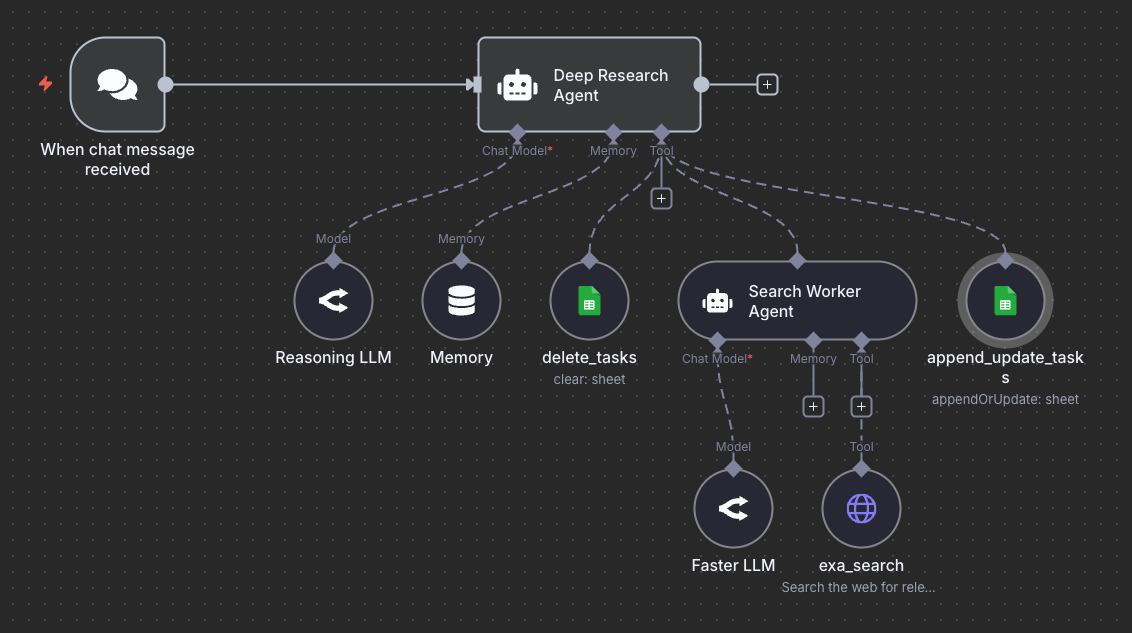
上下文工程面临的挑战
这个智能体系统的第一版暴露出一些行为问题,需要通过细致的上下文工程解决。
问题一:任务执行不完整
**问题:**运行工作流时,编排智能体经常创建三个搜索任务,却只执行其中两个,没有明确说明就跳过第三个。
**原因:**系统提示词没有明确约束任务完成要求。智能体自行判断哪些搜索有必要,导致行为不一致。
**解决方法:**可以采用两种方式。
- 灵活方式(当前采用):允许智能体判断必要的搜索,但必须明确解释为何跳过某项任务。
- 严格方式:明确要求执行所有计划中的搜索任务。
下面是增强系统提示词的原文示例:
text
You are a deep research agent responsible for executing comprehensive research tasks.

TASK EXECUTION RULES:
- For each search task you create, you MUST either:
  1. Execute a web search and document findings, OR
  2. Explicitly state why the search is unnecessary and mark it as completed with justification

- Do NOT skip tasks silently or make assumptions about task redundancy
- If you determine tasks overlap, consolidate them BEFORE execution
- Update task status in the spreadsheet after each action
问题二:调试时缺少可见信息
**问题:**如果没有适当的日志和状态跟踪,很难知道智能体为什么作出某个决策。
**解决方法:**在这个示例中,可以用表格或文本文件实现简单的任务管理系统,包含以下字段:
- 任务 ID。
- 搜索查询。
- 状态:待办
todo、执行中in_progress、已完成completed。 - 结果摘要。
- 时间戳。
这些信息有助于实时调试智能体决策、理解执行流程、发现行为模式,并为后续迭代提供数据。
上下文工程实践原则
1. 消除提示词歧义
不好的示例:
text
Perform research on the given topic.更好的示例:
text
Perform research on the given topic by:
1. Breaking down the query into 3-5 specific search subtasks
2. Executing a web search for EACH subtask using the search_tool
3. Documenting findings for each search in the task tracker
4. Synthesizing all findings into a comprehensive report
2. 明确表达预期
不要假设智能体知道你的要求。应明确说明:
- 必须执行和可选的行动。
- 质量标准。
- 输出格式。
- 决策标准。
3. 提供可观测性
在系统中加入调试机制:
- 记录智能体的决策及可获取的解释信息。
- 在外部存储中跟踪状态变化。
- 记录工具调用与结果。
- 捕获错误和边界情况。
提示
仔细观察智能体系统的每次运行。异常行为和边界情况都是改进上下文工程的机会。
4. 根据实际行为迭代
上下文工程是一个迭代过程:
- 部署带有初始上下文的智能体。
- 观察生产环境中的实际行为。
- 识别与预期的偏差。
- 改进系统提示词和约束。
- 测试并验证改动。
- 重复上述过程。
5. 平衡灵活性与约束
需要权衡两种方式:严格约束更可预测,但适应性较弱;灵活指导适应性更强,但可能不一致。应根据具体用途选择。
进阶上下文工程方法
分层上下文架构
上下文工程贯穿智能体构建的各个阶段。对于某些智能体,把上下文理解为分层结构会更有帮助。这个基础系统可以分为四层:
- 系统层:智能体的核心身份和能力。
- 任务层:当前任务的具体指令。
- 工具层:每个工具的描述和使用规范。
- 记忆层:相关的历史上下文和经验。
动态调整上下文
另一种方式是动态调整上下文。结合本例,可以依据任务复杂度、可用资源、先前执行历史以及错误模式来调整。
验证上下文
评估是确认上下文工程能否改善智能体表现的关键。部署前应验证:
- 完整性:是否覆盖所有重要场景?
- 清晰度:是否存在歧义?
- 一致性:不同部分是否相互协调?
- 可测试性:能否验证实际行为?
常见问题
1. 约束过多
**问题:**规则太多会让智能体缺少灵活性,无法处理边界情况。
示例:
text
NEVER skip a search task.
ALWAYS perform exactly 3 searches.
NEVER combine similar queries.
更好的方法:
text
Aim to perform searches for all planned tasks. If you determine that tasks are redundant, consolidate them before execution and document your reasoning.2. 定义不足
**问题:**模糊指令会导致难以预测的行为。
示例:
text
Do some research and create a report.更好的方法:
text
Execute research by:
1. Analyzing the user query to identify key information needs
2. Creating 3-5 specific search tasks covering different aspects
3. Executing searches using the search_tool for each task
4. Synthesizing findings into a structured report with sections for:
   - Executive summary
   - Key findings per search task
   - Conclusions and insights
3. 忽略错误情况
**问题:**上下文没有说明出错时应该怎样处理。
**解决方法:**可以为智能体增加错误处理指令:
text
ERROR HANDLING:
- If a search fails, retry once with a rephrased query
- If retry fails, document the failure and continue with remaining tasks
- If more than 50% of searches fail, alert the user and request guidance
- Never stop execution completely without user notification
如何衡量效果
可以跟踪以下指标:
- 任务完成率:成功完成任务的比例。
- 行为一致性:相似输入下智能体行为的相似程度。
- 错误率:失败和意外行为出现的频率。
- 用户满意度:输出的质量和实用性。
- 调试时间:识别并修复问题所需的时间。
上下文工程应是一项持续实践,而非一次性工作。它需要系统地观察智能体行为,认真分析失败与边界情况,反复改进指令和约束,并严格测试每次改动。
原作者将在后续指南中进一步解释这些原则。运用这些方法,有助于构建可靠、可预测且能够有效处理复杂任务的智能体。
原文课程信息
查看面向生产环境的智能体课程。原文优惠码 PROMPTING20 可额外优惠 20%,有效性以课程方说明为准。