
外观
OpenAI 4o 图像生成指南
这是一份使用 4o 图像生成模型的实用指南,介绍原文发布时的功能、操作方式和局限。
什么是 4o 图像生成模型?
4o 图像生成是集成在 ChatGPT 中的 OpenAI 图像模型。它能生成写实图像、接收图片并进行变换,也能遵循详细指令,在图像中生成文字。
原文说明,OpenAI 确认该模型采用自回归方式,与 GPT-4o 大语言模型使用相同架构,生成图像的方式类似语言模型生成文本。这让图中文字渲染、精细编辑和基于参考图的编辑得到改善。
如何访问
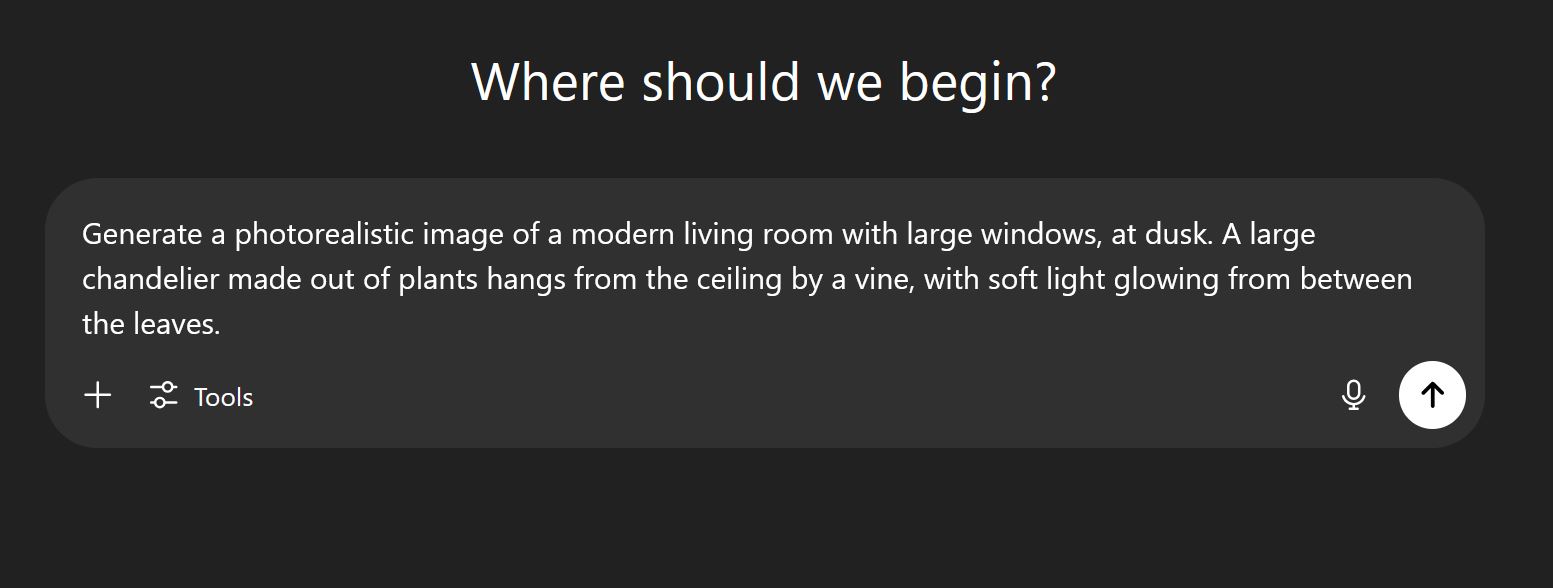
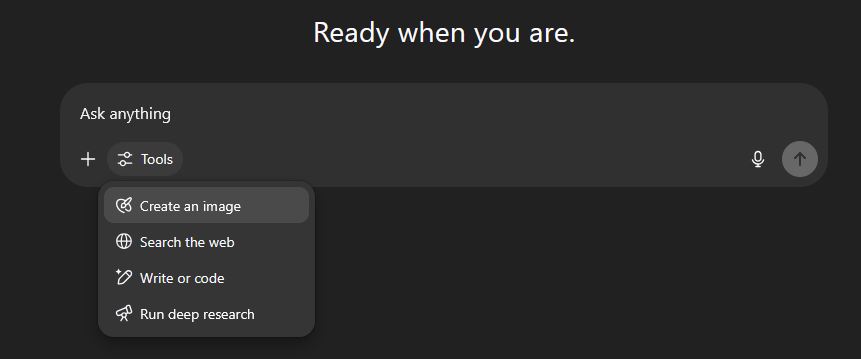
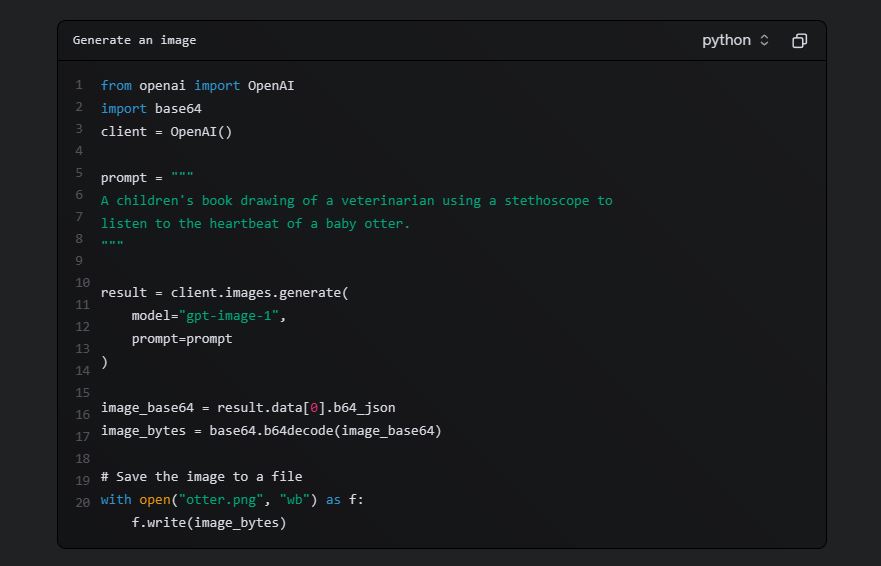
在 ChatGPT 网页或移动应用中,可以直接输入图像生成请求,也可以在工具菜单中选择“创建图片”。原文还介绍了通过 Sora 或 OpenAI API 的 gpt-image-1 使用该模型的方式。
直接输入文字,例如“生成一张……的图片”:
在工具菜单中选择“创建图片”:
也可以使用 OpenAI API:
原文列出的可配合该图像生成能力使用的模型包括:gpt-4o、gpt-4o-mini、gpt-4.1、gpt-4.1-mini、gpt-4.1-nano 和 o3。这些是历史版本资料,当前支持情况请查对应文档。
图像生成模型能做什么?
支持的画面尺寸与比例:
- 正方形 1:1,1024 × 1024,原文中的默认尺寸。
- 横向 3:2,1536 × 1024。
- 纵向 2:3,1024 × 1536。
**参考图格式:**PNG、JPEG、WEBP 和非动画 GIF。
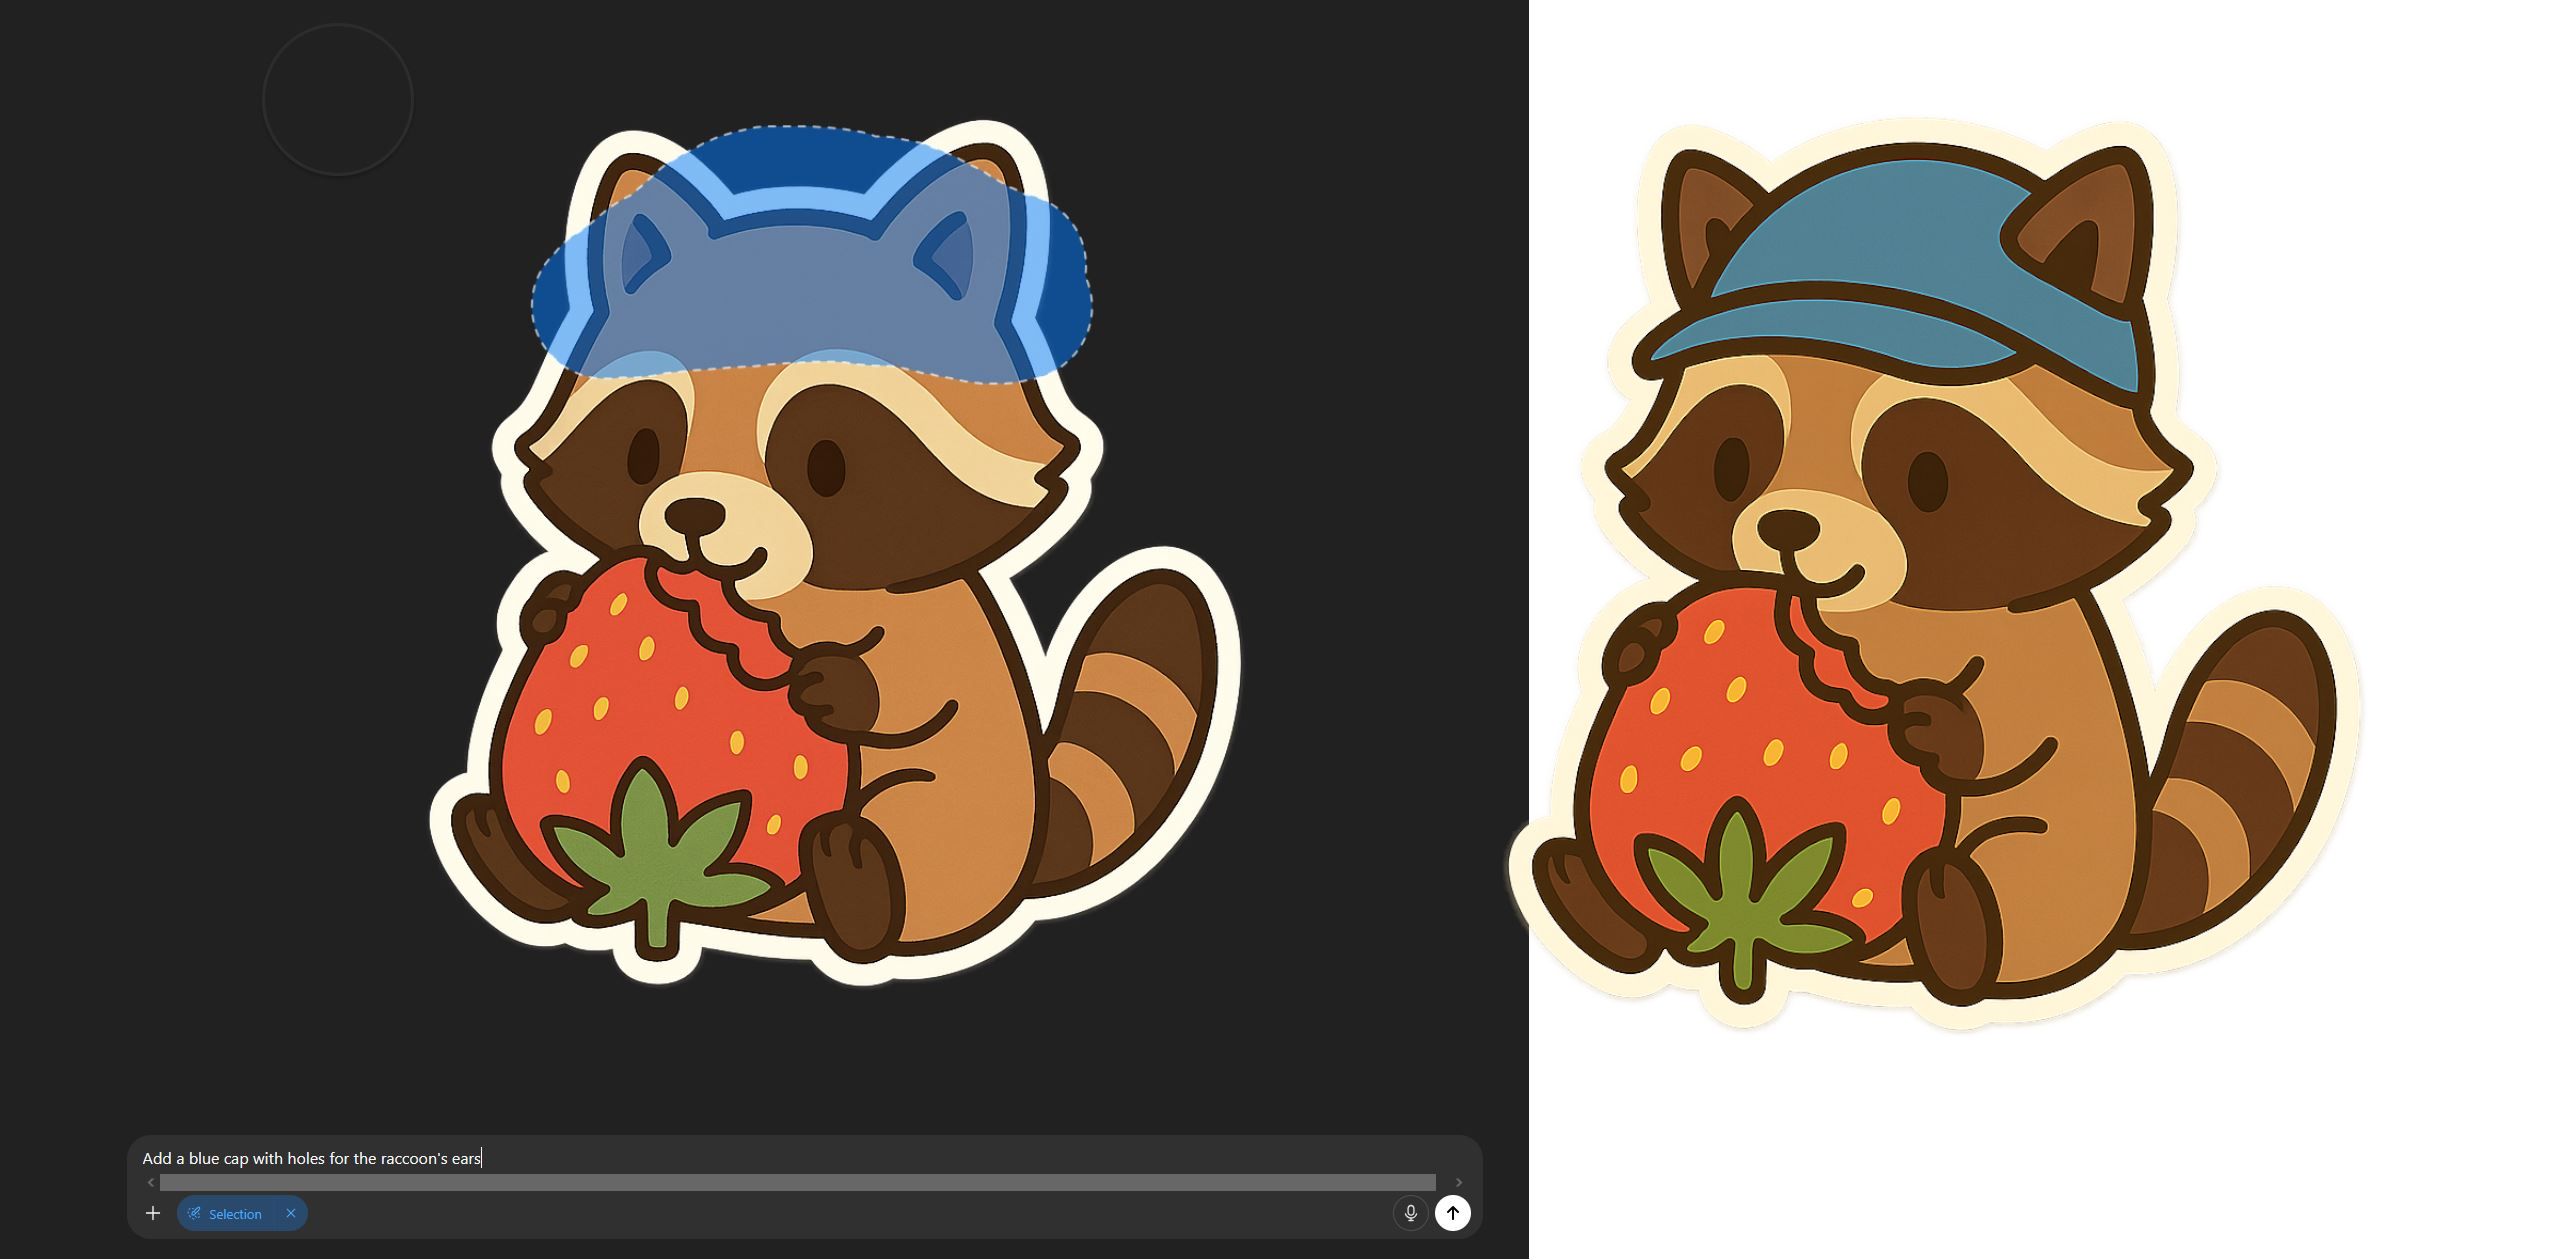
**局部重绘。**原文说明,这一操作适用于同一聊天中生成的图片。
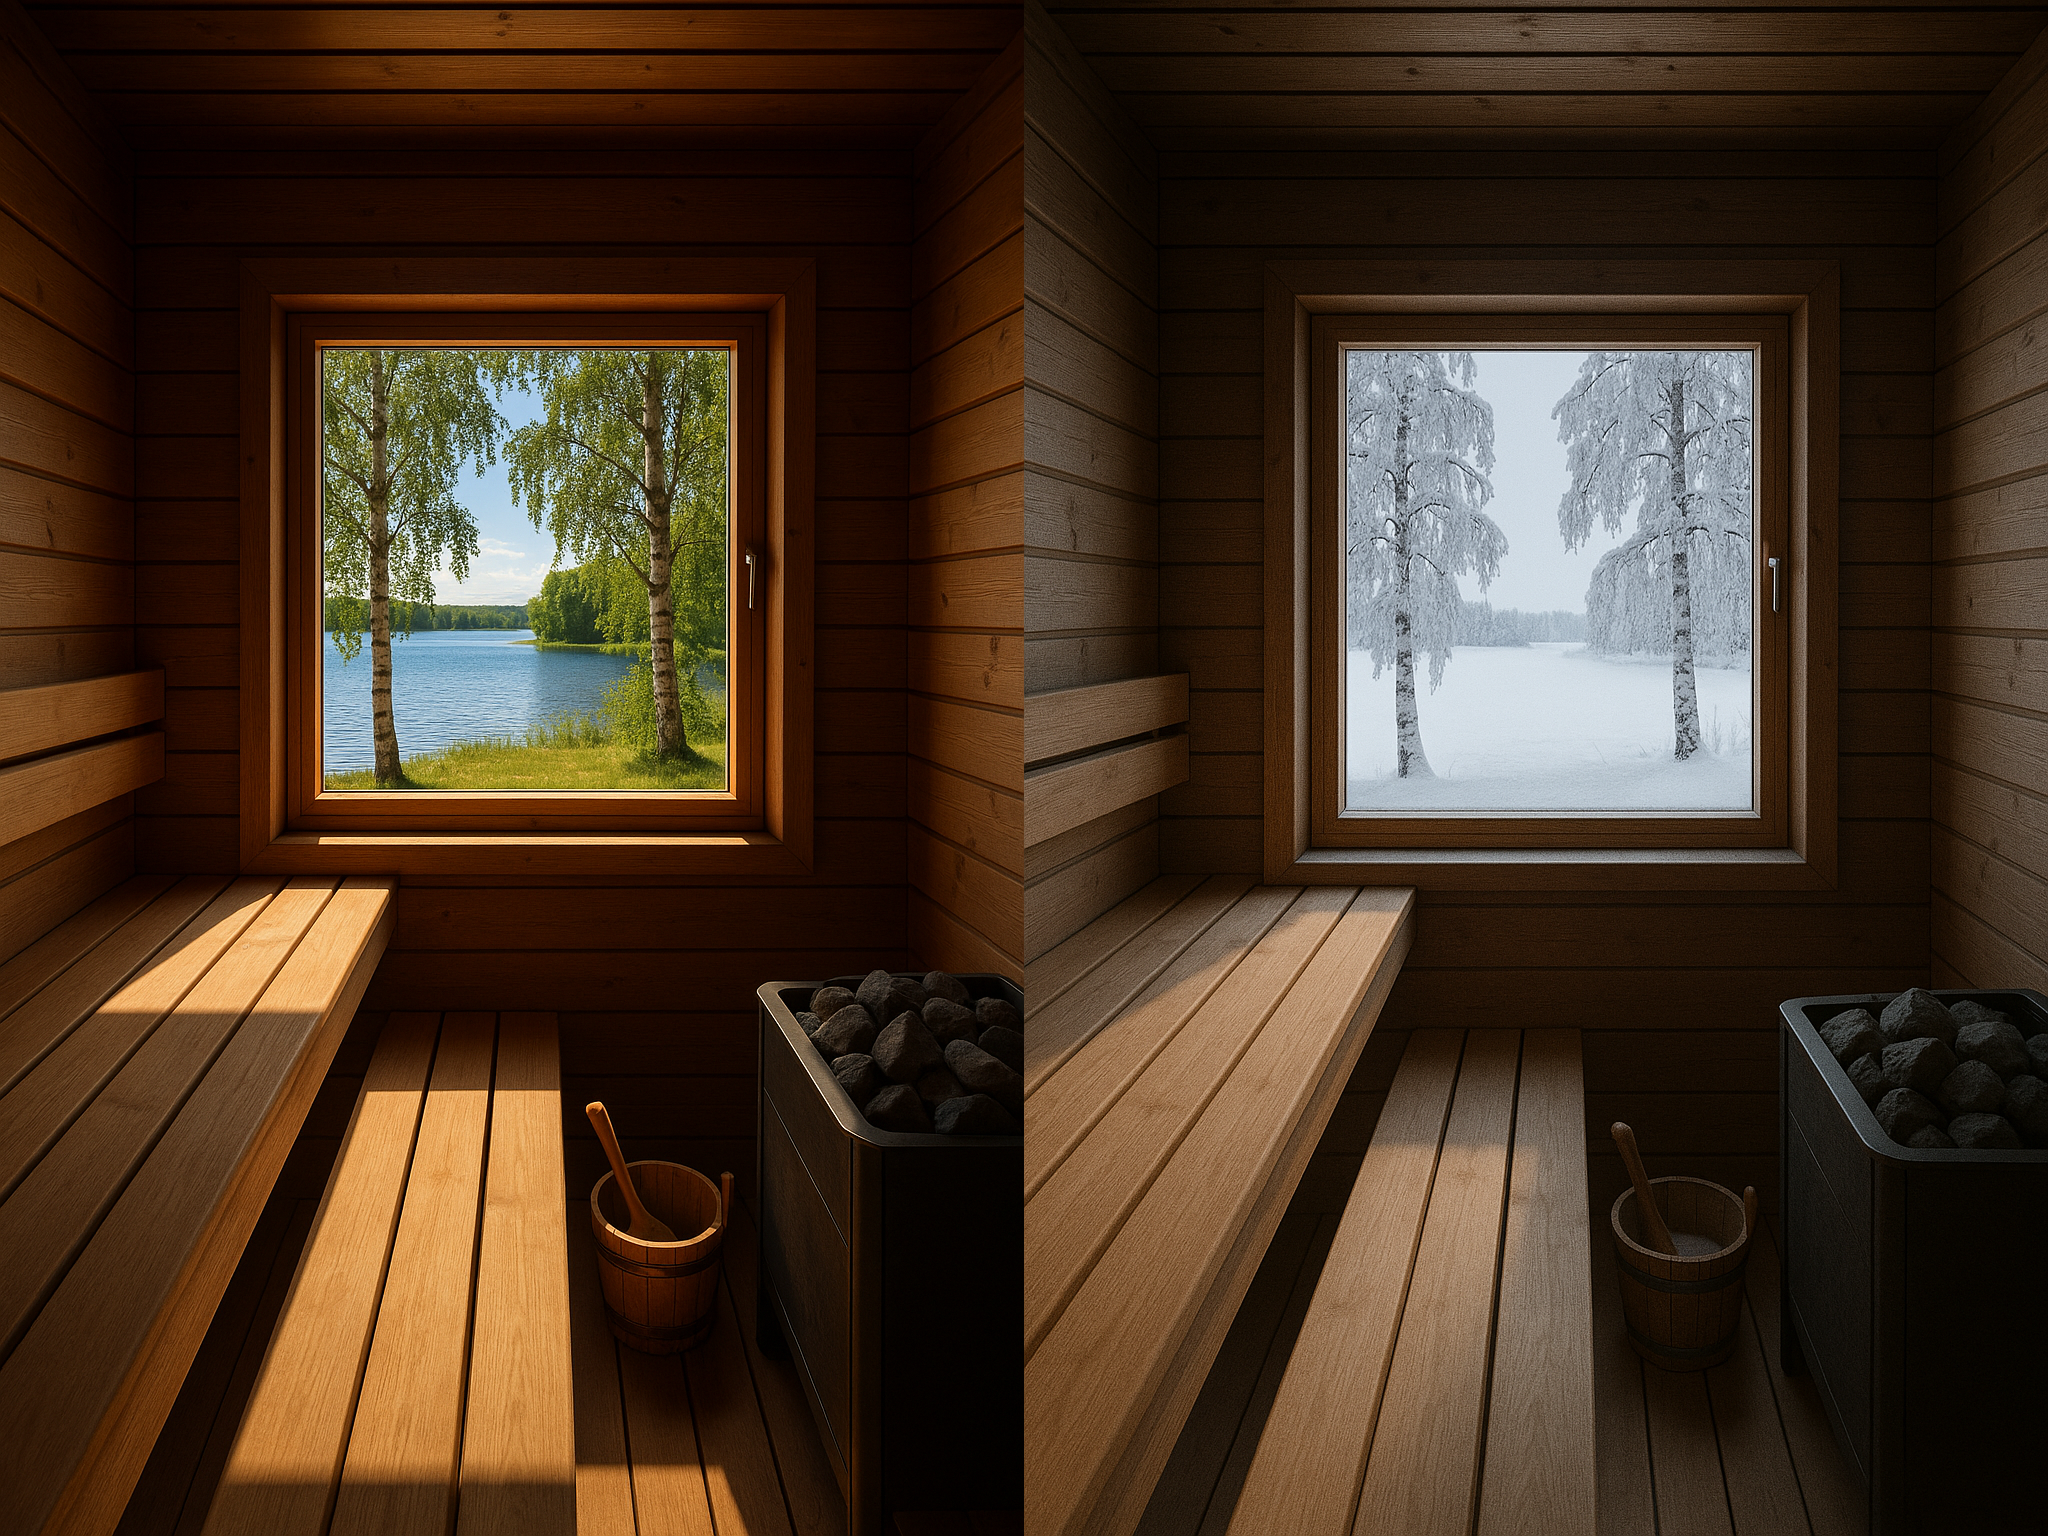
**通过提示词编辑。**例如询问“如果变成冬天,会是什么样?”
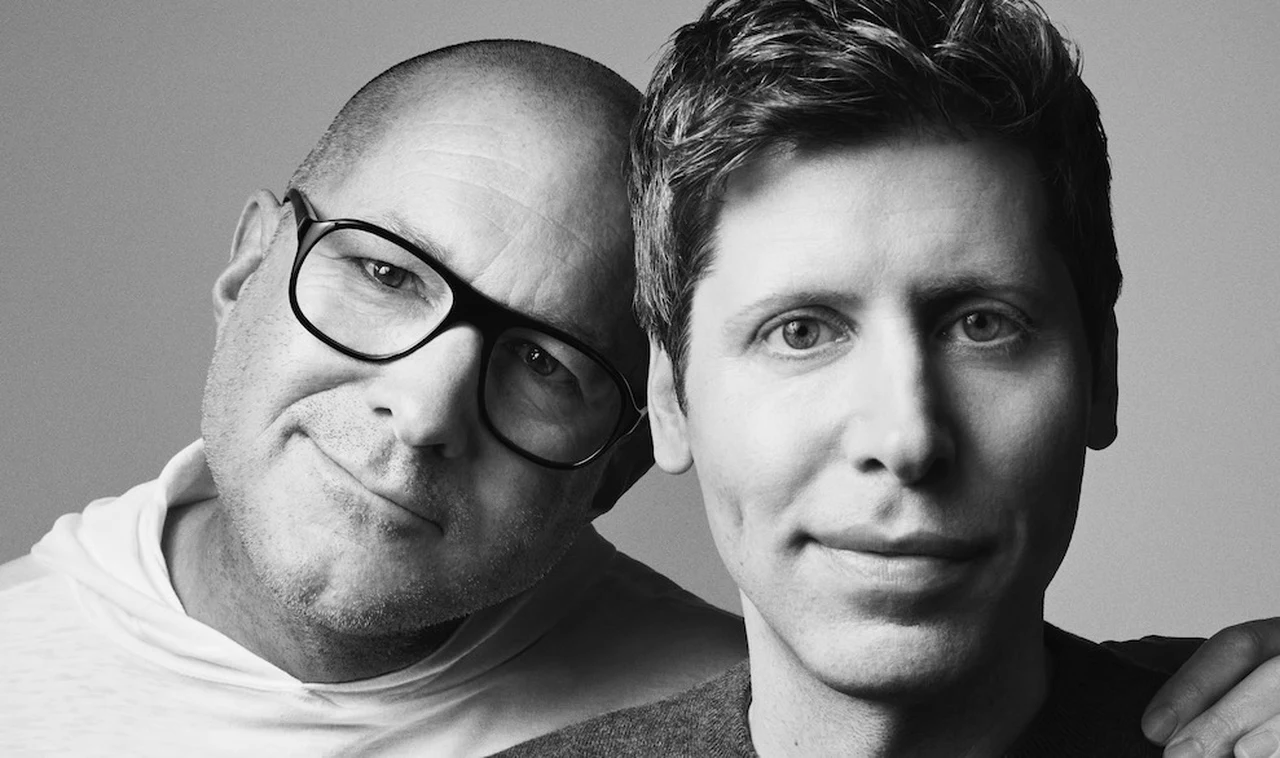
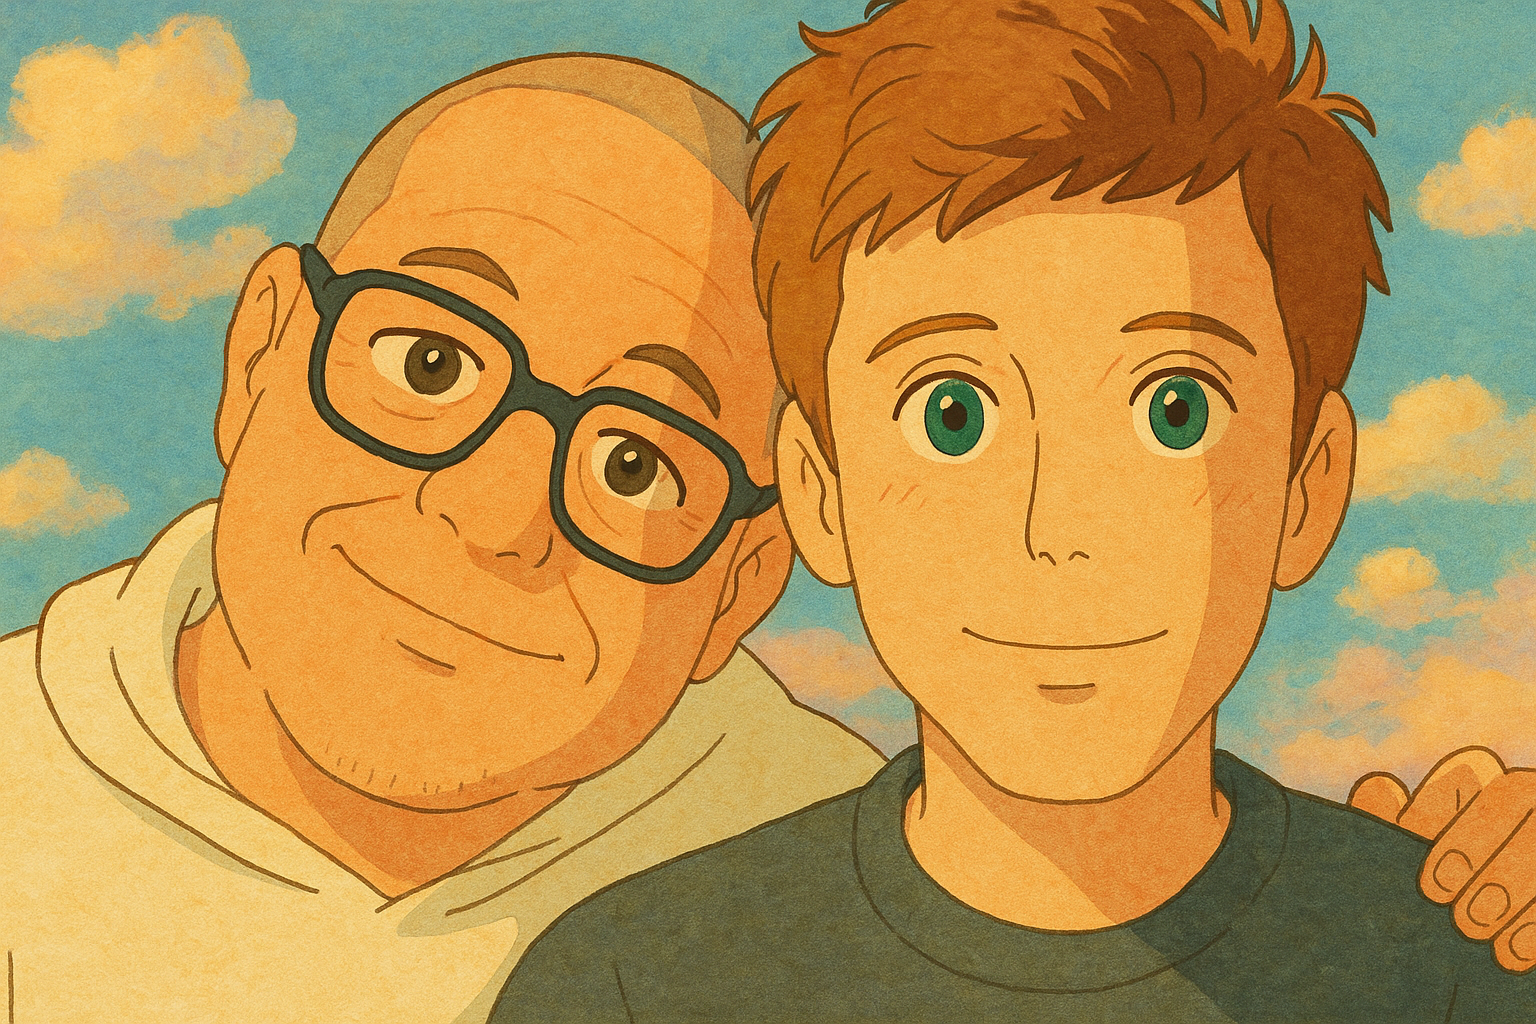
**参考图与风格迁移。**提供参考图后,模型可以更换纹理或图像风格。模型发布时,将照片转换为吉卜力风格的玩法曾广泛传播。
**透明背景 PNG。**需要在提示词中明确写出“透明 PNG”或“透明背景”。
在图像中生成文字。
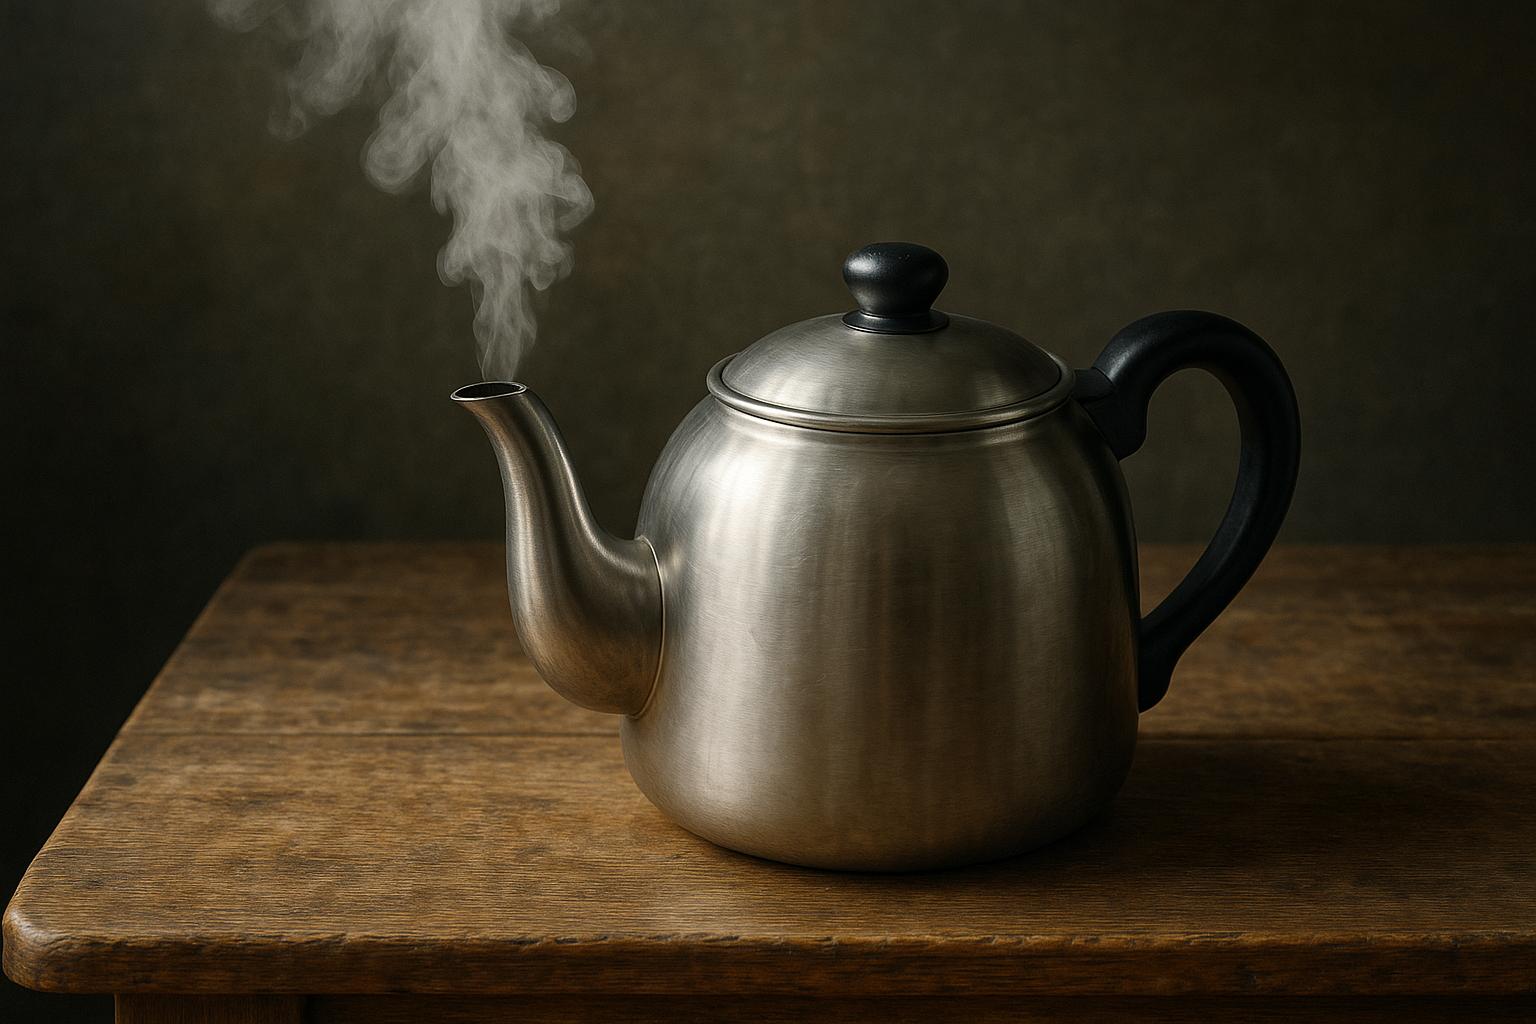
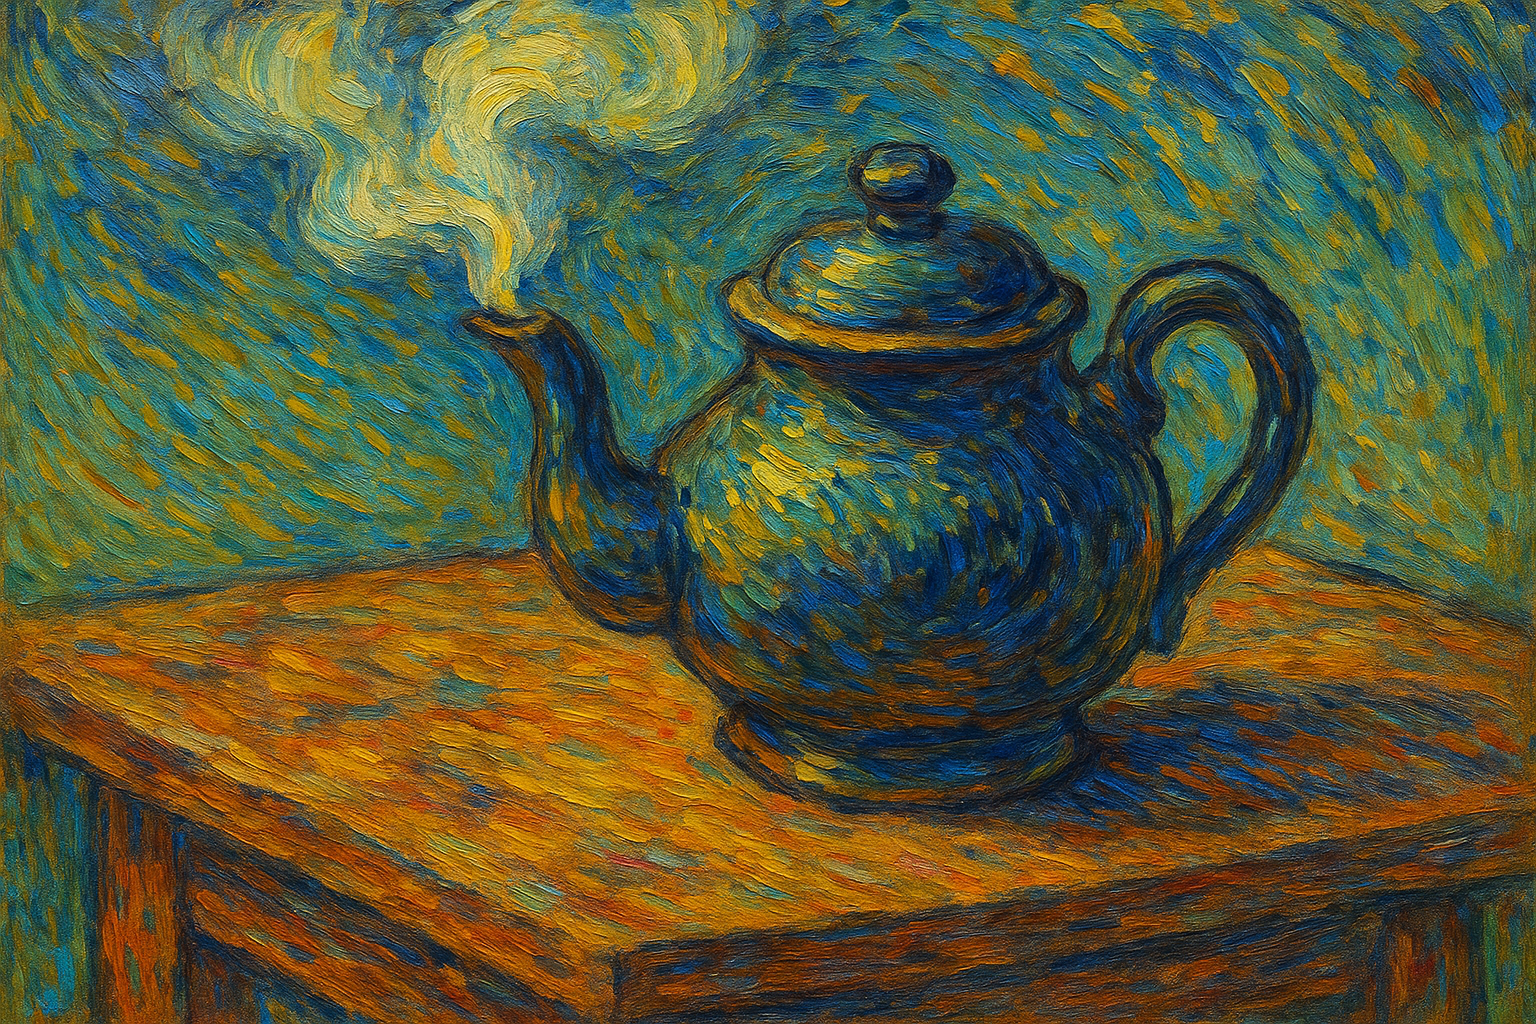
将同一主题生成不同风格。
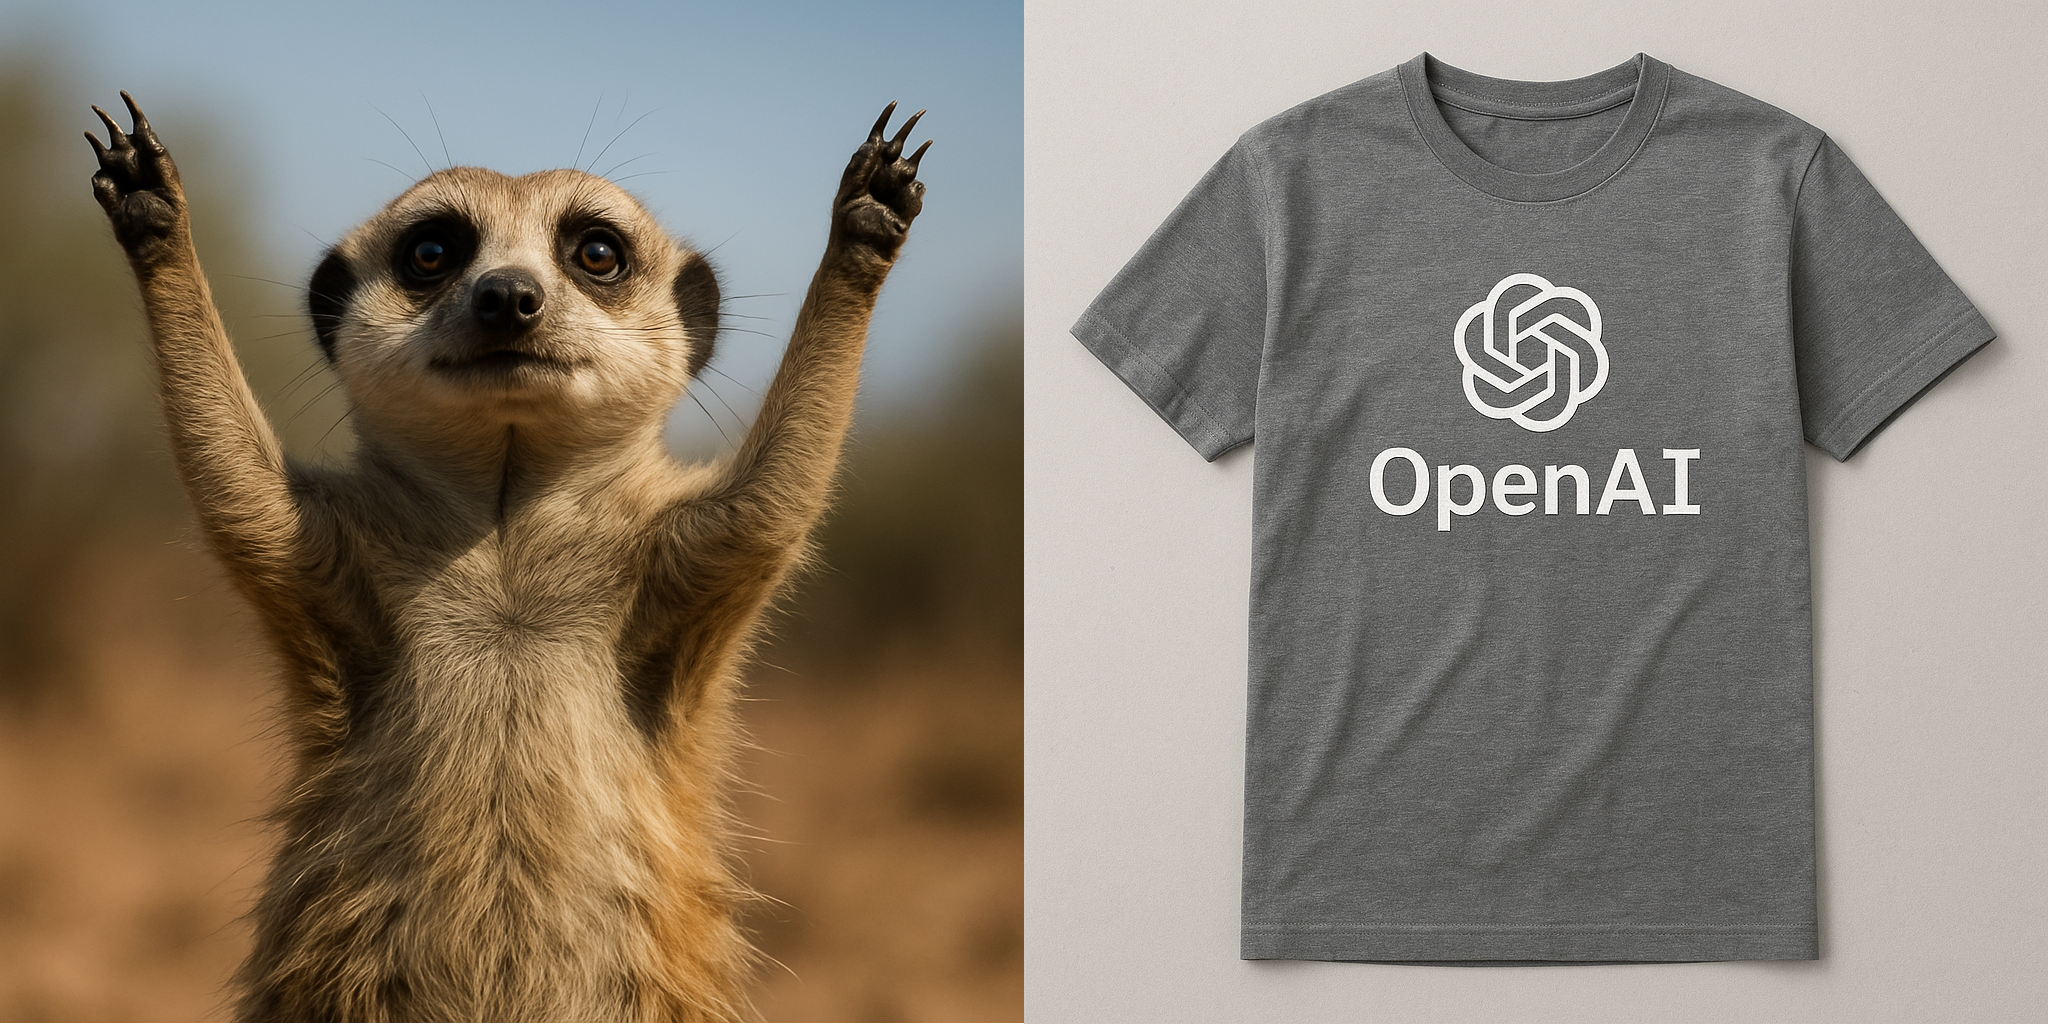
组合图像。
提示词技巧
详细描述带来更多控制
如果提示词描述不足,ChatGPT 往往会自行补充细节。这适合快速尝试或探索,但如果你已经有明确想法,应写出具体、详细的描述。
提示
如果不知道如何描述,可以让 o3 根据你的想法编写三个适合 4o 图像生成的不同提示词,并补齐细节,再从中选择喜欢的部分组合使用。
指定光线、构图和风格
有明确目标时,应在提示词中说明光线、构图和风格。模型能够根据一般信息推测这些要素,但若追求特定效果,就需要准确描述。希望画面像由某种相机或镜头拍摄,也可以写入提示词。
其他需要考虑的要素包括主体、表现媒介、环境、颜色和情绪。
根据任务选择模型
原作者认为,4o 适合快速完成单次编辑或简单生成。
如果预计需要多个步骤,可以使用推理模型。反复增加、删除元素时,推理模型更有利于保持风格、字体和颜色等一致要素。可参考这个缩略图制作过程。
明确画面比例
即使使用参考图,也最好说明所需比例。模型可能根据提示词中的线索选择比例,例如火箭画面常采用 2:3;如果没有明确要求,则可能默认 1:1。
原文测试提示词:
A high-resolution photograph of a majestic Art Deco-style rocket inspired by the scale and grandeur of the SpaceX Starship, standing on a realistic launch pad during golden hour. The rocket has monumental vertical lines, stepped geometric ridges like the American Radiator Building, and a mirror-polished metallic surface reflecting a vivid sunset sky. The rocket is photorealistic, awe-inspiring, and elegant, bathed in cinematic warm light with strong shadows and a vast landscape stretching to the horizon.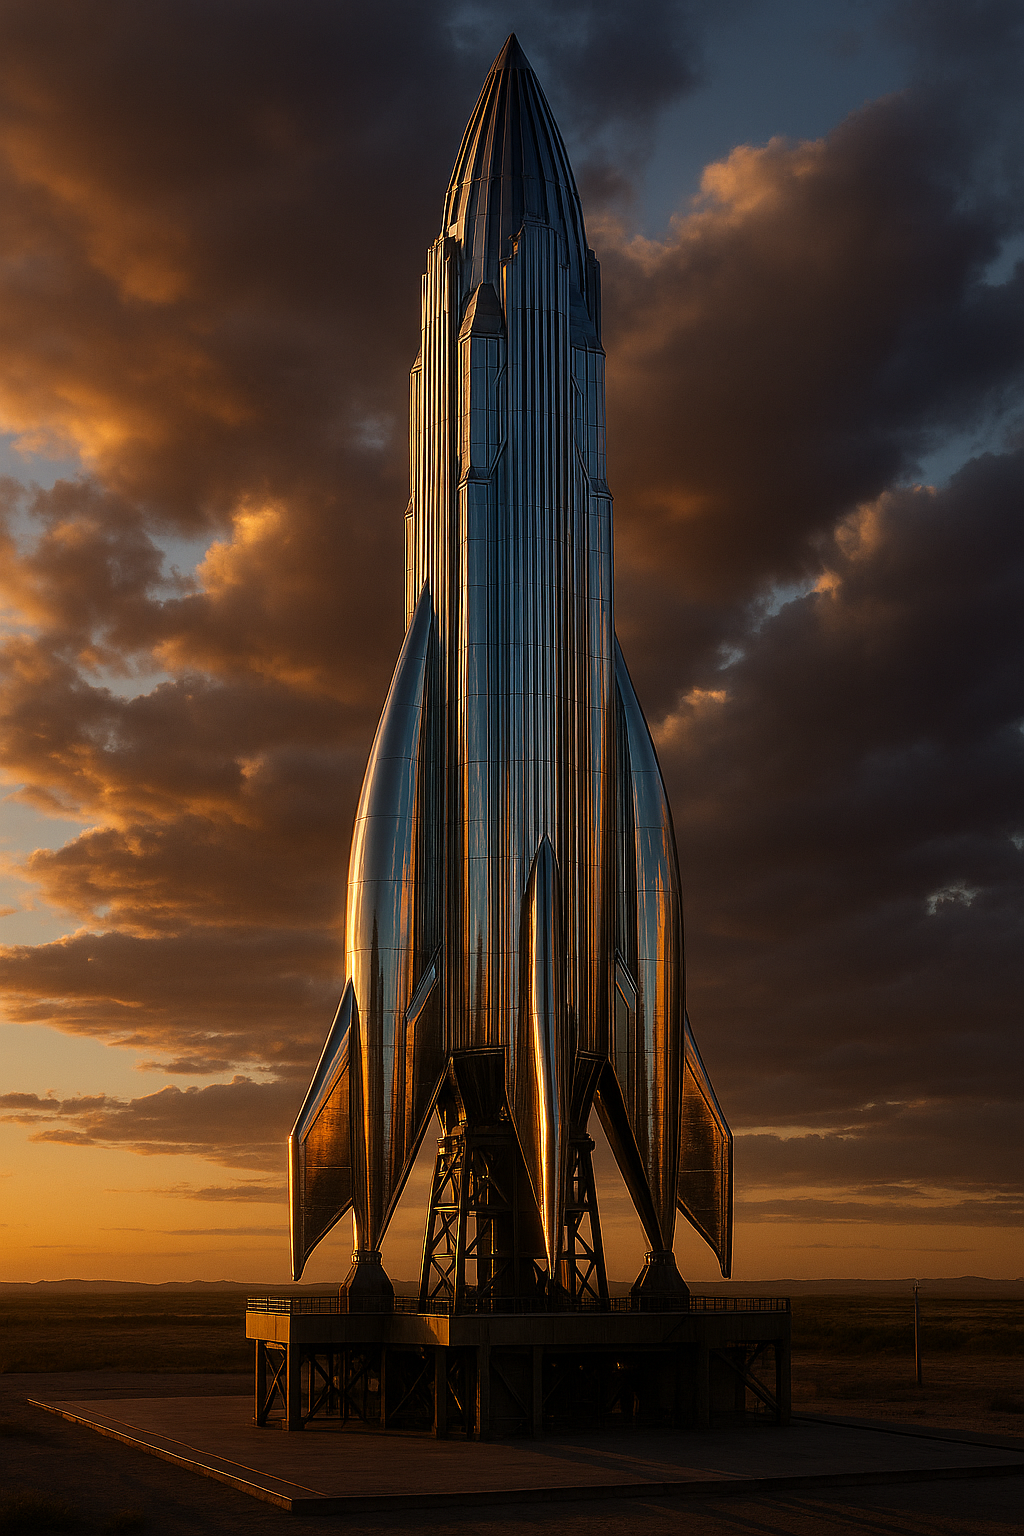
注意同一对话中的图像一致性
模型会参考同一聊天里已经生成的图片。这有利于修改小细节,但也可能限制创意变化。对于相互独立的图像任务,最好每次开启新聊天。
提示
如果前几次生成都偏离目标,可以要求模型说明用于生成图片的提示词,检查描述重点是否错位,再开新聊天使用修改后的提示词。
一个提示词生成多张图片
原文介绍,o3、o4-mini 等推理模型可以在一个提示词下生成多张图片,但必须明确提出,而且并非每次都成功。查看示例对话。
原文测试提示词:
Generate an image of [decide this yourself], in the style of an oil painting by Van Gogh. Use a 3:2 aspect ratio. Before you generate the image, recite the rules of this image generation task. Then send the prompt to the 4o Image Generation model. Do not use DALL-E 3. If the 4o Image Generation model is timed out, tell me how much time is left until you can queue the next prompt to the model.

Rules:
- Use only the aspect ratio mentioned earlier.
- Output the prompt you sent to the image generation model exactly as you sent it, do this every time in between image generations
- Create three variations with a different subject, but the same rules. After an image is generated, immediately start creating the next one, without ending your turn or asking me for confirmation for moving forward.
严格遵循提示词仍然困难
包含多个要求的提示词,可能在聊天模型传递给图像模型的过程中发生变化。同一聊天里先前生成的图片,也可能继续影响后续结果,即使你已经修改了提示词。
局限
以下是原文记录的局限,并不代表所有问题在当前版本中仍相同:
- ChatGPT 可能在发送到图像模型前修改最初提示词,尤其在多轮生成、描述不足或提示词过长时。
- 不同用户或订阅的生成额度不明确。OpenAI 表示配额是动态的,可能与订阅及地区服务器负载有关。
- 免费方案的请求可能排队,生成耗时较长。
- 图像可能偏黄;如果提示词或参考图较暗,结果可能过暗。
- 图像生成受 OpenAI 的使用政策约束。如果提示词、参考图或输出触发限制,生成可能被拒绝,已部分生成的图片可能被删除。
- 原文发布时,ChatGPT 内没有图像放大功能。
- 裁剪可能出错,只输出生成画面的一部分。
- 可能出现类似语言模型的幻觉。
- 同时生成很多概念或独立主体较困难。
- 根据图表数据生成精确的可视化效果并不可靠。
- 在图像中生成非拉丁文字较困难。
- 修改错别字等局部请求不一定成功。
Imagegen、gpt-image-1、4o Image Generation、image_gen.text2im等多种名称可能造成混淆。- 即使指定比例,有时仍会生成错误比例。
实践建议
原文个性化设置建议
原文建议在“ChatGPT 应具备哪些特征”中添加:不要使用 DALL-E 工具,始终使用新的图像生成工具;如果工具超时,应告知用户,而不是改用 DALL-E。此建议针对原文发布时的产品行为。
- 达到生成上限后,原文建议向 ChatGPT 询问何时恢复额度;具体是否能够查询,以当时产品提供的信息为准。
- 在提示词里明确使用“绘制”“编辑”等词,有助于表达意图。
- 原文建议使用推理模型时查看界面提供的思考摘要,了解提示词编写与修改过程中关注的重点。
可以尝试的用途
- 标志设计:提供参考图和详细描述,通常需要多轮修改,可以使用推理模型。示例。
- 营销素材:以现有视觉素材为参考,更改文字、产品或环境。
- 涂色书页面:用 2:3 比例制作定制线稿。示例。
- 贴纸:记得说明透明背景。示例。
- 材质迁移:用一张图提供材质,再将它应用到另一张图或提示词中的主体上。示例。
- 室内设计:拍摄房间,再要求改变家具或空间特征。示例。
提示词与对话示例
- 课程缩略图制作过程
- 多轮图像生成中的主体修改
- 透明背景上的纹理图标
- 无人机送花创业公司的标志设计
- 吃草莓的浣熊白色轮廓贴纸
- 一条提示词生成多张图片
- 用文字把夏季图像改成冬季
- 吉卜力风格中打盹的大黄蜂
- 在房间照片中添加家具
- 用两张参考图迁移材质