
外观
为 RAG 生成合成数据集
RAG 场景中的合成数据
机器学习工程师经常遇到标注数据缺乏或数量很少的问题。传统做法是启动漫长的数据收集与标注流程,几个月后才能开始开发解决方案。
随着大语言模型出现,一些产品的开发方式发生了变化:现在可以利用模型的泛化能力,几乎立即验证想法或开发 AI 功能。如果结果基本符合预期,再开始传统开发流程。
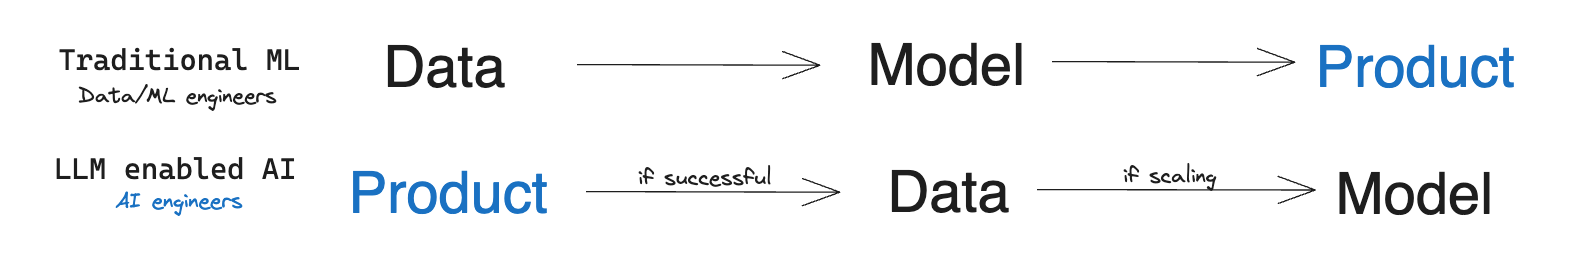
图片来源:S. Wang,《AI 工程师的兴起》。
检索增强生成(RAG)是其中一种逐渐普及的方法。它适用于知识密集型任务,因为这类任务不能只依赖模型内部知识。RAG 将信息检索组件与文本生成模型结合,更多介绍见对应章节。
RAG 的关键组件是检索模型:它找到相关文档,再交给大语言模型处理。检索效果越好,产品或功能的结果通常越好。理想情况下,检索模型开箱即用,但换一种语言或进入专业领域时,效果经常下降。
例如,需要构建一个用捷克语回答捷克法律与司法实践问题的聊天机器人,或者面向印度市场的税务助手(类似 OpenAI 在 GPT-4 演示中的案例)。检索模型可能漏掉最相关的文档,整体表现变差,从而限制系统质量。
一种解决思路是利用现有大语言模型合成数据,再训练新一代语言模型、检索器或其他模型。这可以理解为:通过基于提示词的查询生成,把大语言模型的能力蒸馏到常规规模的编码器中。虽然蒸馏过程计算量较大,但可显著降低推理成本,也可能改善低资源语言或专业领域的效果。
本指南使用 ChatGPT、GPT-4 等能按照指令生成大量内容的模型。Dai 等人(2022)提出,只需 8 个人工标注示例,加上大量未标注文档(例如已经解析的全部法律文本),就能获得接近当时最先进水平的效果。这说明,在领域标注数据不足、难以进行监督微调的任务上,合成数据有助于训练专用检索器。
生成领域专用数据集
使用模型时,需要简短说明任务,并手动标注少量示例。不同检索任务的搜索意图不同,因此对“相关”的定义也不同。对于同一组查询与文档,其相关性可能随搜索意图而完全改变。
例如,论点检索任务可能寻找支持性论据,也可能要求反对意见,后者可参考 ArguAna 数据集。
下面使用英文示例方便对照原始实验。数据也可以使用其他语言,因为 ChatGPT 和 GPT-4 对低资源语言也有一定处理能力。
提示词:
Task: Identify a counter-argument for the given argument.

Argument #1: {insert passage X1 here}

A concise counter-argument query related to the argument #1: {insert manually prepared query Y1 here}

Argument #2: {insert passage X2 here}
A concise counter-argument query related to the argument #2: {insert manually prepared query Y2 here}

<- paste your examples here ->

Argument N: Even if a fine is made proportional to income, you will not get the equality of impact you desire. This is because the impact is not proportional simply to income, but must take into account a number of other factors. For example, someone supporting a family will face a greater impact than someone who is not, because they have a smaller disposable income. Further, a fine based on income ignores overall wealth (i.e. how much money someone actually has: someone might have a lot of assets but not have a high income). The proposition does not cater for these inequalities, which may well have a much greater skewing effect, and therefore the argument is being applied inconsistently.

A concise counter-argument query related to the argument #N:
输出:
punishment house would make fines relative income这类提示词一般可以表示为:
其中, 和 分别是任务专用的文档描述与查询描述; 是提供给 ChatGPT 或 GPT-4 的任务指令; 是需要模型为其生成查询的新文档。
用于后续本地模型训练的,只有最后一个文档 和对应生成的查询。这种方法适用于已经有目标检索语料库 ,但新任务的标注查询—文档对数量有限的情况。
完整流程如下:
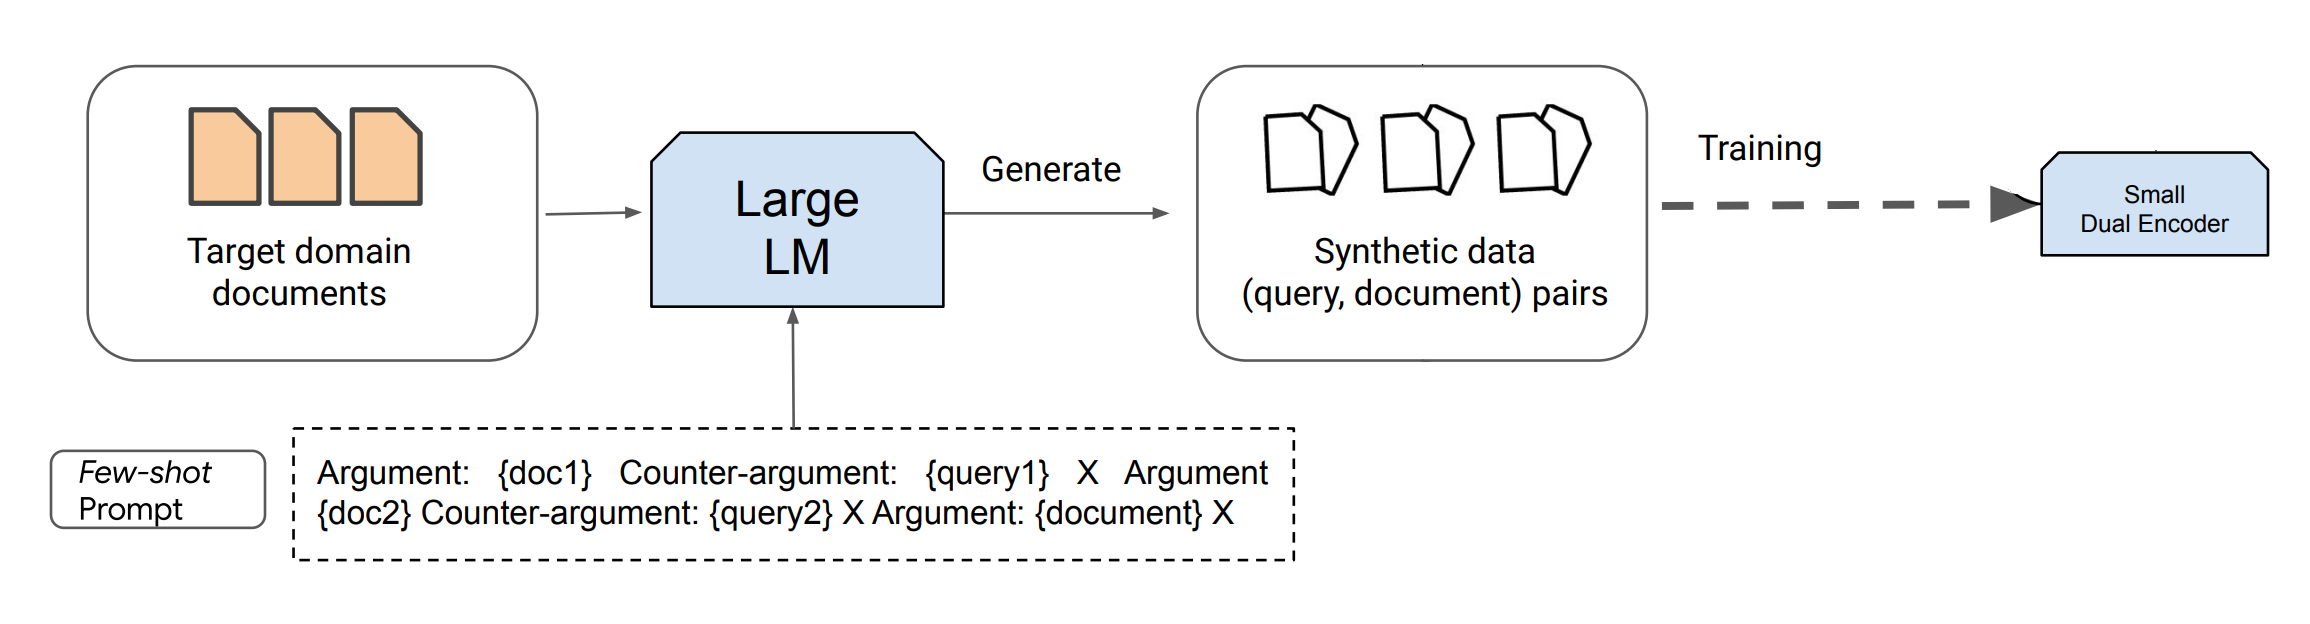
图片来源:Dai 等人(2022)。
人工标注示例必须认真处理。可以先准备较多示例,例如 20 个,再随机选取 2 至 8 个加入提示词,这样能在不显著增加标注成本的情况下提高生成数据的多样性。
示例应具有代表性、格式正确,还应体现目标查询的长度、语气等细节。示例和指令越准确,生成的数据越有利于检索器训练。质量不佳的少样本示例会损害最终训练效果。
多数情况下,使用成本较低的 ChatGPT 就足够,它能处理较不常见的领域及非英语语言。假设包含指令和 4 至 5 个示例的提示词约为 700 个词元,每段因检索器限制不超过 128 个词元,生成查询约为 25 个词元。按原文所用 GPT-3.5 Turbo 历史 API 单价,输入每千词元 0.0015 美元,输出每千词元 0.002 美元,为 50,000 篇文档生成数据约需:
50,000 × (700 × 0.001 × $0.0015 + 25 × 0.001 × $0.002) = $55
也可以为同一篇文档生成 2 至 4 个查询。对于捷克法律这样的特定领域,而非英语新闻检索这样的通用场景,继续训练带来的收益往往值得投入。上述成本是原文的历史估算,并非当前报价。
50,000 并非随意选取的数字。Dai 等人(2022)指出,要达到合成数据训练模型的质量,人工标注数据量大致需要这个规模。即使产品上线前只收集 10,000 个示例,也可能需要至少一个月,人工成本超过一千美元,明显高于生成合成数据再训练本地检索模型的费用。原作者认为,这种技术有机会在数天内带来两位数幅度的指标增长;实际收益仍取决于任务与评估条件。
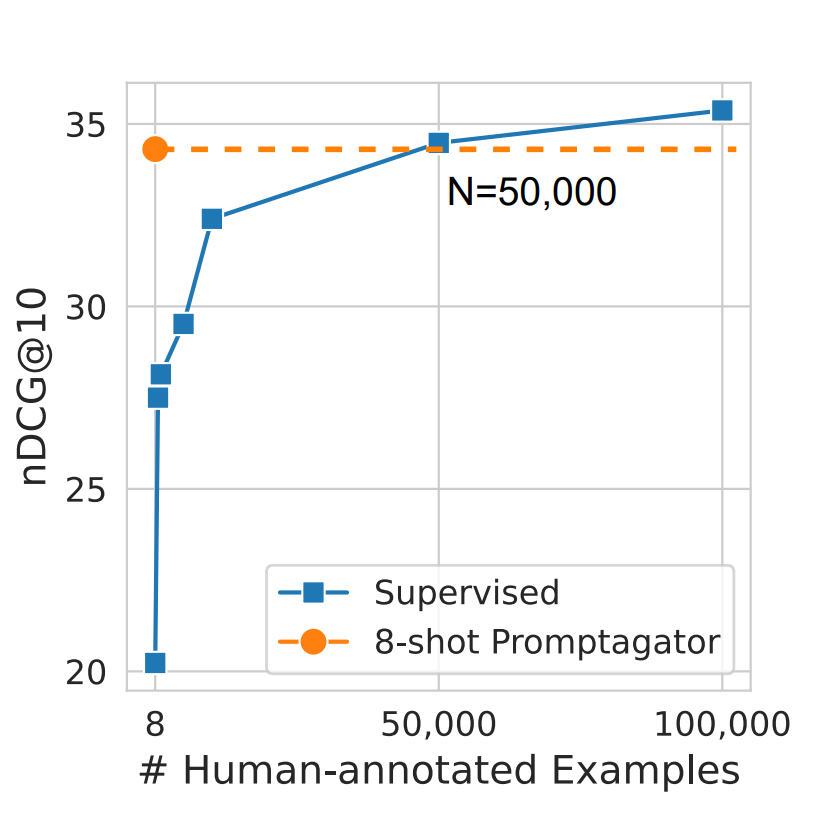
图片来源:Dai 等人(2022)。
同一篇论文还为 BeIR 基准的部分数据集提供了以下提示词模板:
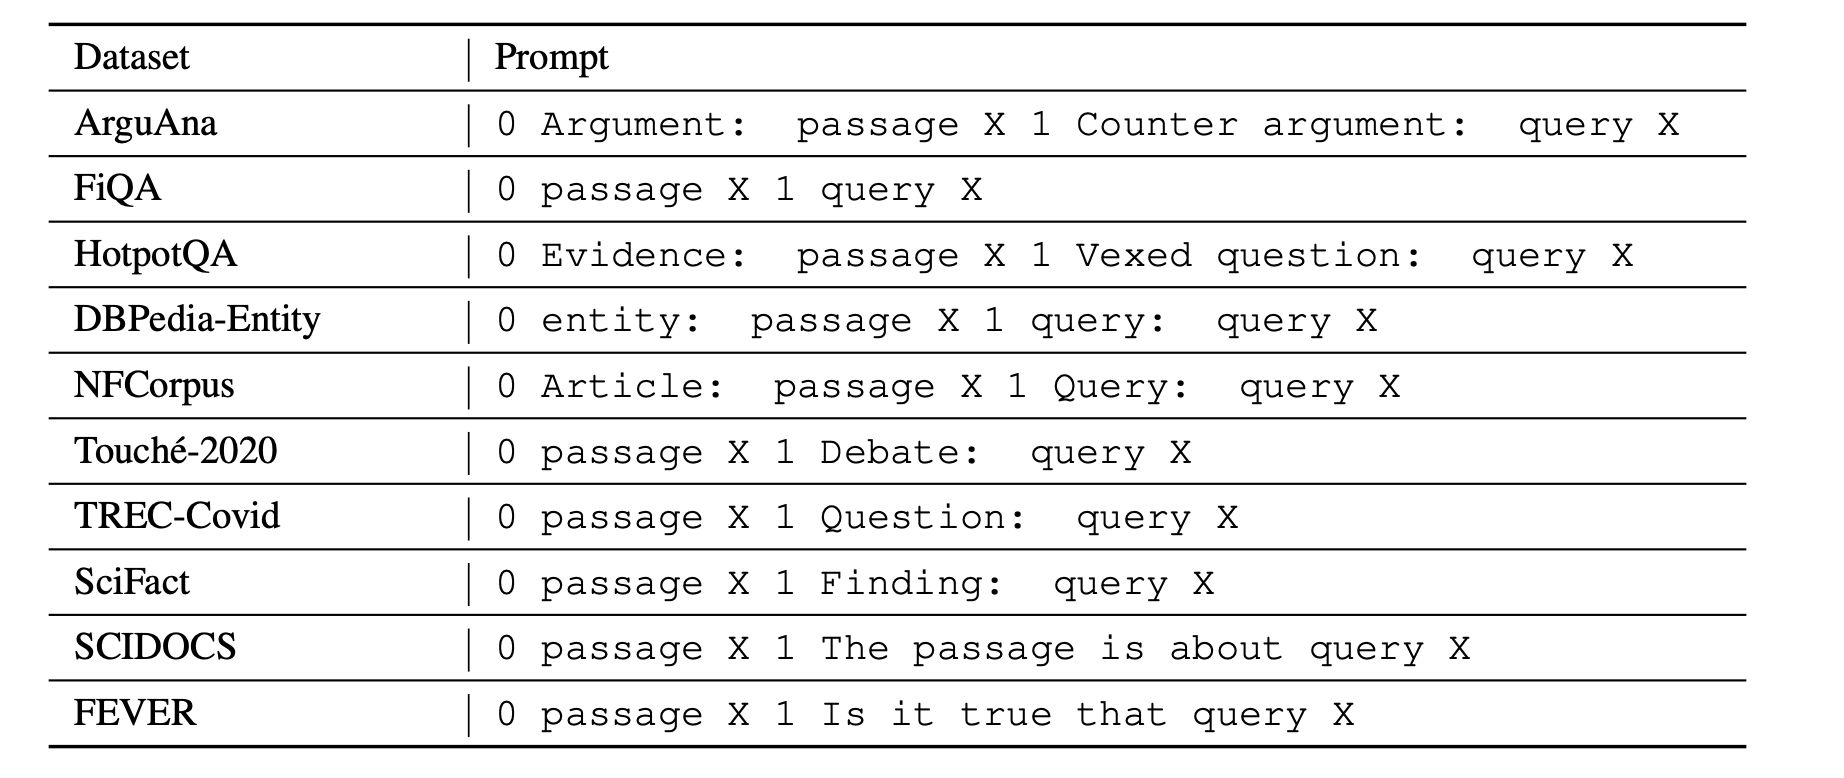
图片来源:Dai 等人(2022)。