
外观
Llama 3 模型介绍
Meta 推出了 Llama 3 系列,首批包括 80 亿和 700 亿参数的预训练与指令微调模型。
架构细节
- 使用标准的仅解码器 Transformer。
- 词表包含约 12.8 万个词元。
- 使用 8K 词元序列训练。
- 采用分组查询注意力(GQA)。
- 预训练数据超过 15 万亿词元。
- 后训练结合监督微调(SFT)、拒绝采样、PPO 和 DPO。
表现
根据原文引用的发布结果,指令微调后的 Llama 3 8B 超过 Gemma 7B 和 Mistral 7B Instruct。Llama 3 70B 在多数比较中超过 Gemini 1.5 Pro 和 Claude 3 Sonnet,但在 MATH 基准上稍逊于 Gemini 1.5 Pro。
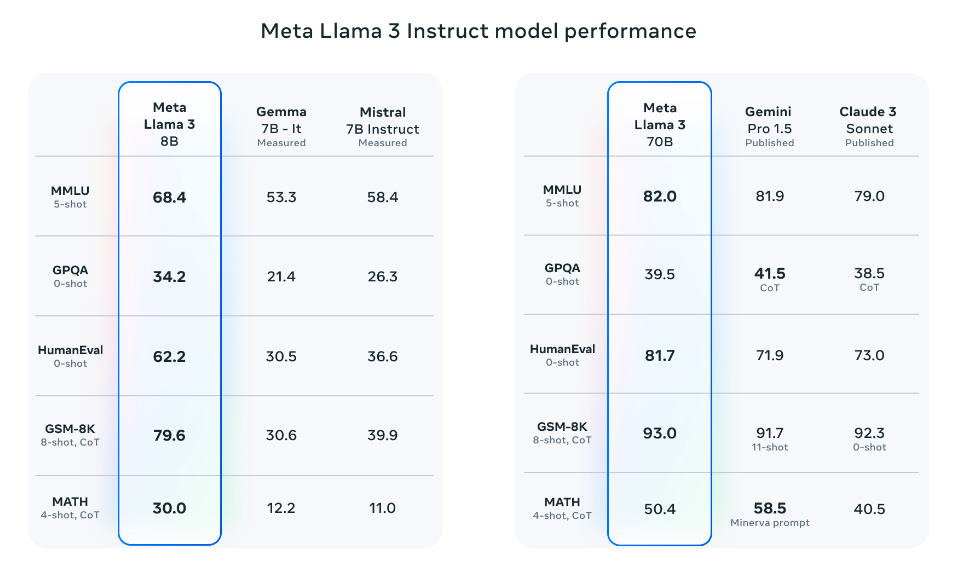
来源:Meta AI。
预训练模型也在 AGIEval 英语测试、MMLU 和 Big-Bench Hard 等基准上超过图示中的其他模型。
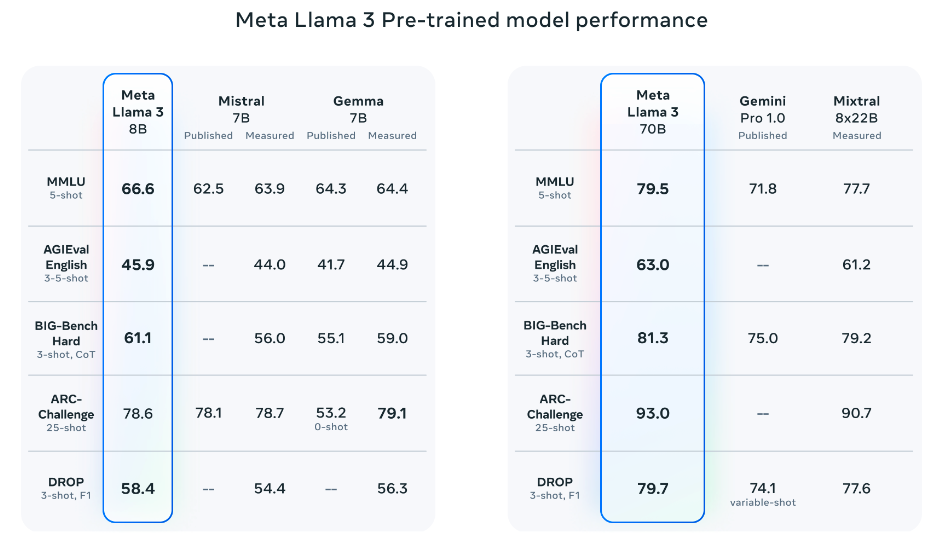
来源:Meta AI。
Llama 3 400B 的早期结果
原文发布时,Meta 表示正在训练约 4,000 亿参数的模型,并推进多模态、多语言和更长上下文支持。以下是截至 2024 年 4 月 15 日检查点在 MMLU、Big-Bench Hard 等基准中的结果,属于当时的开发信息。
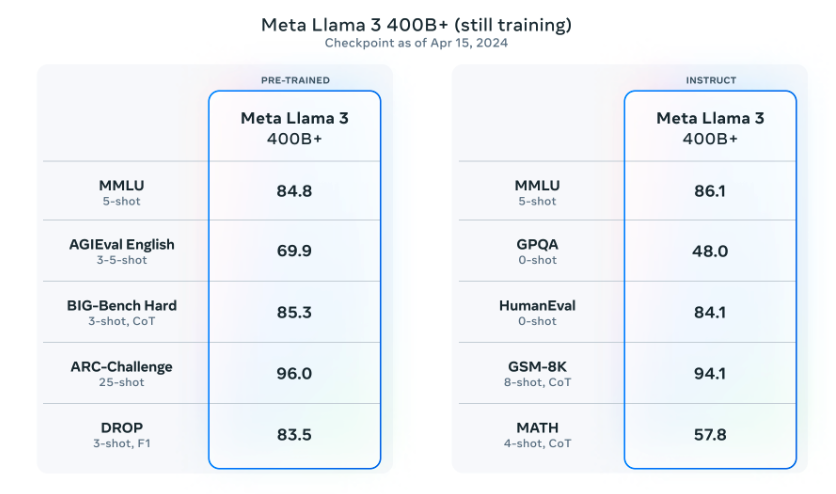
来源:Meta AI。
许可信息见模型卡。