
外观
推理大语言模型使用指南
目录
什么是推理大语言模型?
大型推理模型(LRM),也称推理大语言模型,是经过专门训练、能够执行原生思考或思维链推理的模型。原文列出的常见例子包括 Gemini 2.5 Pro、Claude 3.7 Sonnet 和 o3。
可在 ChatGPT 的 o3 和 Google AI Studio 的 Gemini 2.5 Pro 中尝试以下原文提示词:
What is the sum of the first 50 prime numbers? Generate and run Python code for the calculation, and make sure you get all 50. Provide the final sum clearly.常见推理模型
原作者在下列表格中整理了常见模型的特性与优势:
可通过以下资源跟踪基准表现:
设计模式与应用场景
智能体系统中的规划
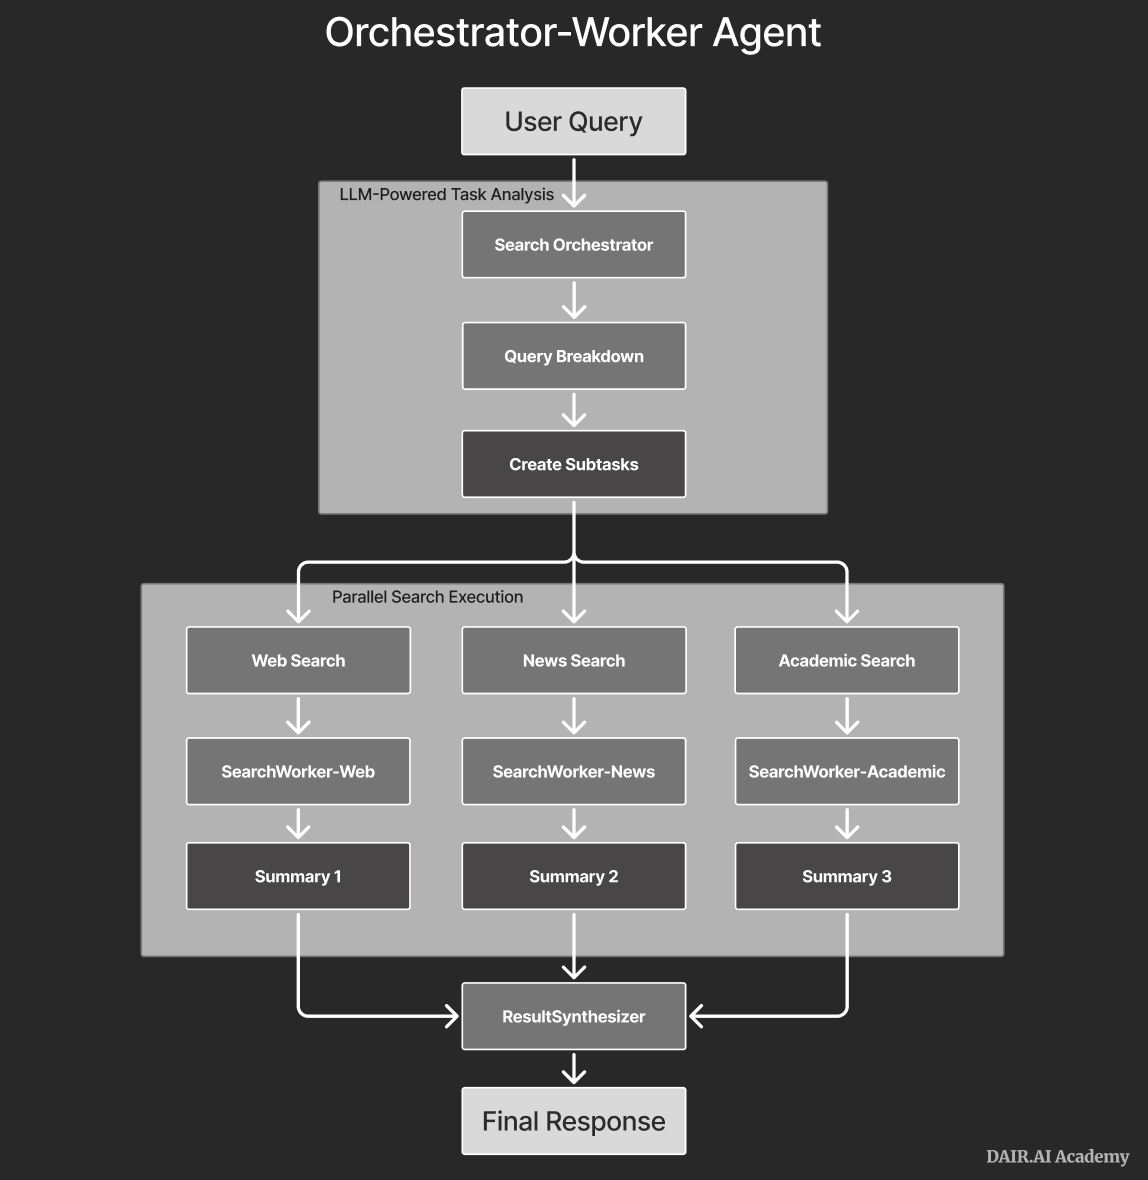
规划是帮助智能体完成复杂任务的重要组成。在深度研究系统中,规划可以确定需要执行哪些搜索,并随着任务推进持续指导系统。
下面的搜索智能体先拆解查询、制定计划,再编排并执行搜索:
智能体 RAG
智能体 RAG 利用推理模型处理复杂知识库或来源,并进行进阶工具使用。它可以通过具备推理链或工具的检索智能体,用函数调用对需要复杂推理的查询和上下文进行路由。
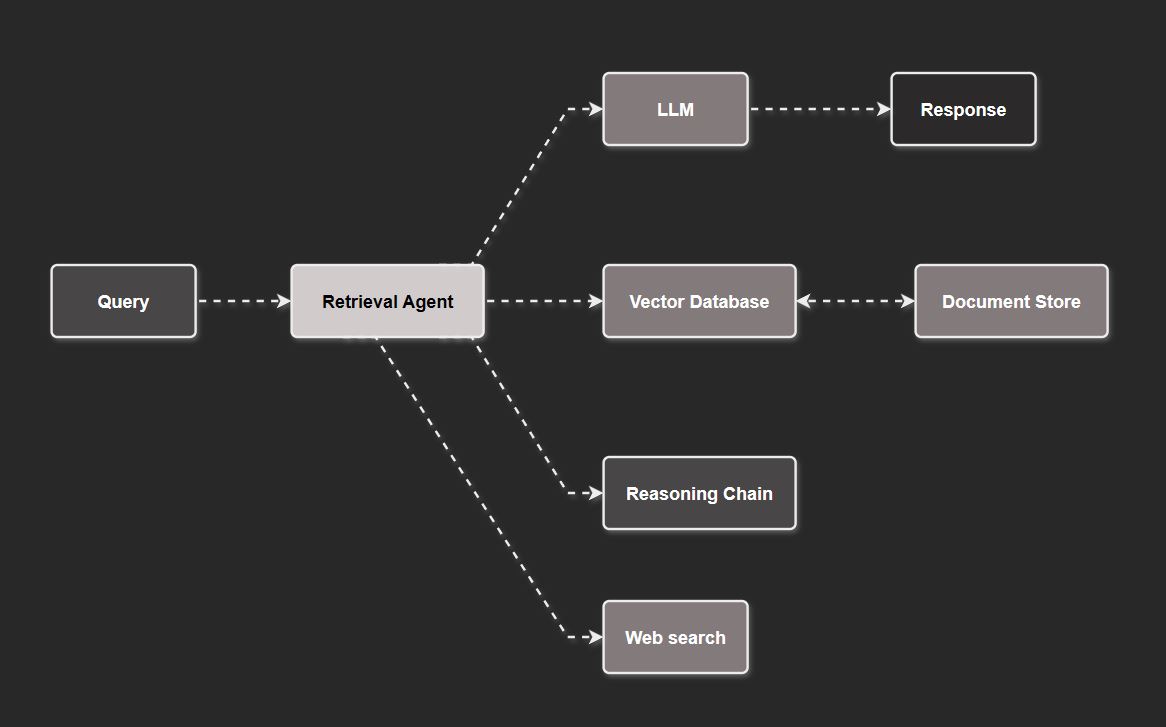
可查看基于 n8n 的基础实现模板,以及视频教程:用推理模型构建智能体 RAG。
使用大语言模型作为评审
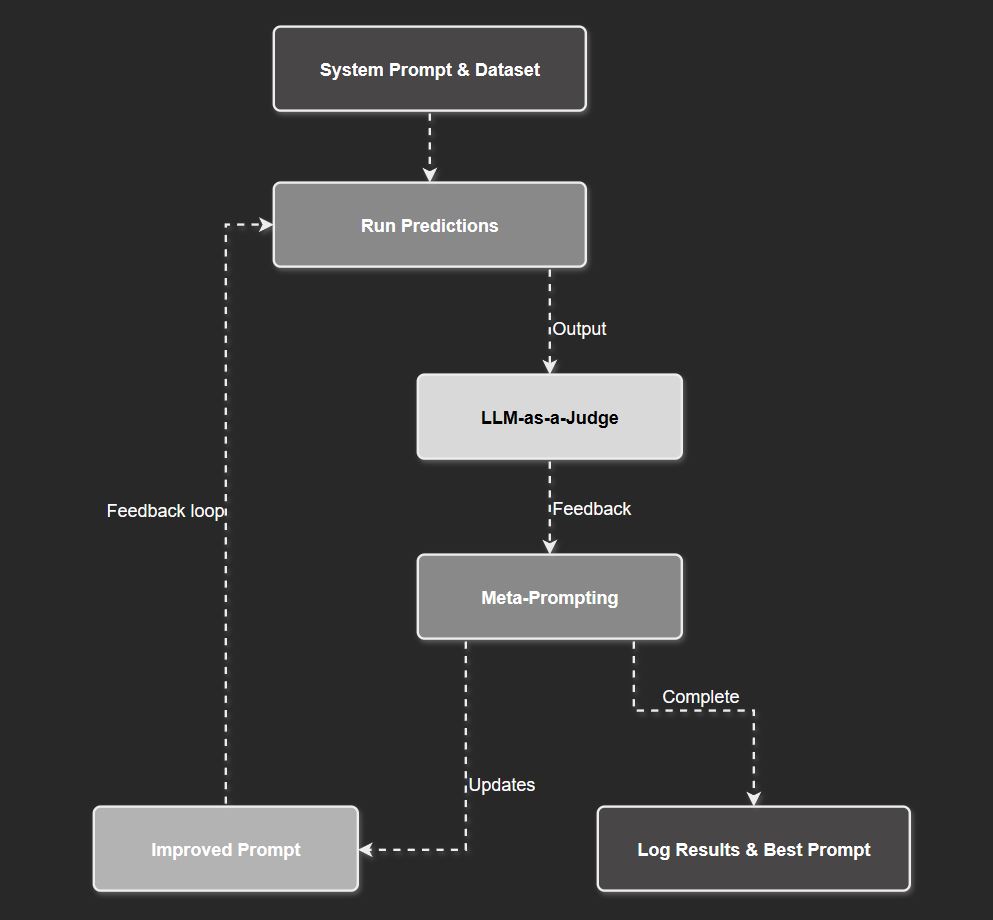
需要自动评估时,可以让大语言模型充当评审(LLM-as-a-Judge),利用它理解大量信息和复杂推理的能力。推理模型适合此类应用。
下图展示了“评估器—优化器”循环:由推理模型驱动的评审智能体先评估预测并给出反馈;元提示词接收当前提示词和反馈,再尝试优化基础系统提示词。
视觉推理
o3 等模型可以结合多个工具进行进阶视觉推理,理解图片,也可借助工具执行缩放、裁剪和旋转等操作,把图像信息纳入推理过程。
其他应用
- 在技术领域的大型复杂数据集中寻找关系并回答问题,例如分析大量不同文档。
- 审查、理解、调试大型代码库,开展算法开发与科学计算编程。
- 处理需要高阶数学解题、实验设计和深入推理的科学任务。
- 文献综述与综合分析。
- 为知识库生成处理规程,优化模型的分步指令,例如元提示。
- 验证数据,提高数据集质量与可靠性。
- 多步骤规划,例如深度研究。
- 为问答系统识别并提取相关信息。
- 处理知识密集、存在歧义的任务。
使用建议
一般使用方式与提示词技巧
**有选择地使用推理。**把推理模型用于应用中真正需要复杂推理的模块,不必覆盖全部功能。将应用模块化、分离职责,有助于找出推理最有价值的位置。
**推理时扩展计算。**总体而言,对多数推理模型,更多思考时间与计算投入可能改善表现,但应通过具体任务评估。
设置思考强度。low 通常更便宜、响应更快;high 使用更多思考时间和词元,响应较慢;medium 在准确性与速度之间折中。
**指令明确。**像使用普通聊天模型一样,说明目标、总体要求、约束与输出格式,减少模型自行假设的空间。不必手动规定所有推理步骤。
**避免强制思维链。**原文建议,对原生推理模型使用简洁直接的指令,避免要求逐步展示思维链;必要时明确回答约束。
**结构化输入输出。**用分隔符组织输入,在复杂智能体应用中使用结构化输出。多数推理模型能够遵循 JSON 或 XML 格式。原作者偏好默认使用 XML,除非明确需要 JSON。Claude 4 等模型的输出形式可能受到提示词结构影响,例如 Markdown 提示词容易引出 Markdown 输出。
**少样本提示。**如果模型难以达到所需效果,可以添加输入—输出示例。示例应与总体指令一致,尤其适合难以用文字描述目标格式、或需要展示应避免行为的情况。
**使用清楚、具体的修饰要求。**更详细的要求可以引导 o3、Claude 4 等生成更复杂、更高质量的代码或搜索结果。例如,Claude 4 文档建议在前端生成中要求“加入经过考虑的细节,例如悬停状态、过渡和微交互”。
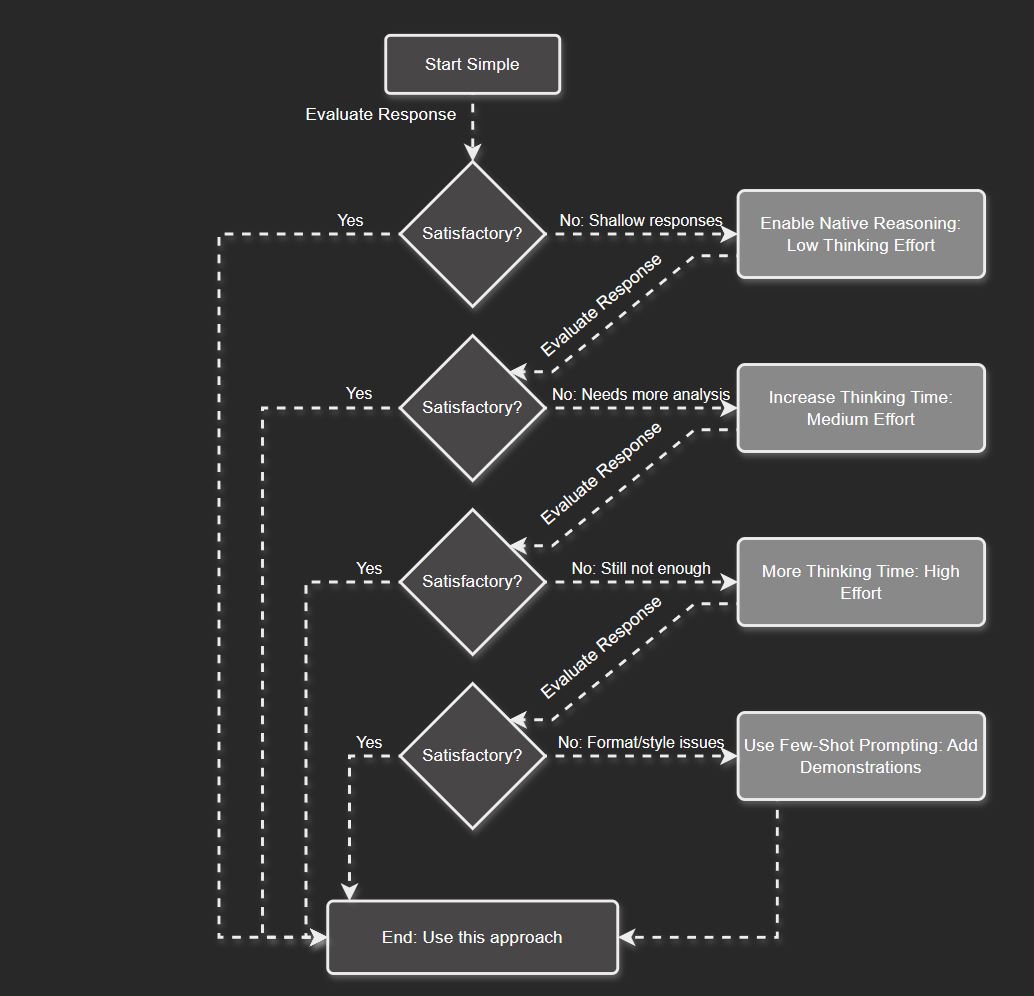
使用混合推理模型
- 从简单模式开始:先关闭思考模式,评估标准回答;此时也可以尝试手动思维链提示。
- 开启原生推理:如果回答浅显或有误,而任务可能受益于深入分析,则开启低强度思考并评估。
- 增加思考时间:低强度不够时,改为中等强度。
- 进一步增加:中等强度仍不足时,再尝试高强度。
- 加入少样本示例:需要改善风格和格式时,提供示范。
推理模型的局限
输出质量
模型有时会混合语言、重复内容、产生不一致的答案、格式问题或不佳的表达风格。遵循对应模型的提示词建议、避免模糊和不必要的指令,可以缓解部分问题。
推理可能影响指令遵循
研究发现,对推理模型显式要求思维链,有时会损害指令遵循。因此需要谨慎使用,甚至避免对原生推理模型再施加此类提示。
论文提出的缓解方法包括:精心挑选少样本示例;让模型自我评审并修改答案;让模型自行判断何时推理;或者使用外部分类器预测推理是否有帮助。
思考过多或过少
指令不合适时,模型可能过度思考,也可能思考不足。明确任务、流程和预期输出格式可以改善。另一种做法是拆分子任务,仅在需要时把复杂任务路由到推理工具。
成本
原文指出,推理模型通常比普通聊天模型更昂贵。应结合调试工具实验,持续评估回答质量,并跟踪词元用量及不稳定输出带来的额外成本。
延迟
推理模型相对较慢,有时还生成无关内容,进一步增加耗时。简洁提示词可以缓解,应用端也可以用流式输出改善感知延迟。较小的推理模型及 Claude 3.7 Sonnet 等模型,可能具有更好的延迟表现。
原作者建议先优化准确性,再优化延迟与成本。
工具调用与智能体能力仍有限
o3 等模型改善了多工具调用,但并行调用仍可能存在问题。原文所讨论的 DeepSeek-R1、Qwen 等模型,如果未专门训练工具调用,也可能表现不佳。
可靠、动态的工具调用有望支持能够在现实世界行动的智能体。推理模型虽然知识丰富,但仍需要提高决策能力,以及对物理世界和数字世界的理解。多模态推理仍是持续研究的方向。
可查看原作者持续维护的推理模型指南文档。
继续学习
原作者推荐以下课程:
- 面向开发者的提示工程:更多推理模型提示与应用方法。
- 进阶 AI 智能体:结合推理模型的多智能体系统、模型评审以及监督者—执行者架构。
- AI 智能体入门:使用 ReAct 等概念构建智能体。
- RAG 入门:智能体 RAG 等设计模式。
原作者的社区论坛提供支持、指导、答疑和专家活动。如有课程问题,可联系 课程方邮箱。
原文课程信息
查看进阶 AI 智能体课程。原文优惠码 PROMPTING20 可额外优惠 20%,有效性以课程方说明为准。