
外观
OLMo 开放语言模型
本指南介绍 OLMo 的模型、数据与评估结果,并收录相关论文和阅读资料。上游原文的提示词示例章节尚未补充。
OLMo 简介
艾伦人工智能研究所发布了 OLMo 模型与框架,旨在完整开放数据、训练代码、模型和评估代码,促进语言模型研究。
首批发布包含四个 70 亿参数变体和一个 10 亿参数模型,均使用至少 2 万亿词元训练。原文还提到后续计划发布 650 亿参数版本,这属于当时的开发计划。
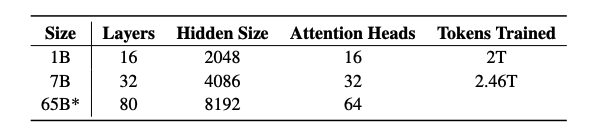
开放内容包括:
代码、权重和中间检查点均以 Apache 2.0 许可发布。
OLMo-7B
OLMo-7B 和 OLMo-1B 均采用仅解码器 Transformer,并借鉴 PaLM、Llama 等模型的改进:不使用偏置项、使用无参数层归一化、SwiGLU 激活、旋转位置编码(RoPE),词表大小为 50,280。
Dolma 数据集
项目还发布了预训练数据集 Dolma:来自七类数据源、覆盖约 50 亿篇文档、总计 3 万亿词元的多样化语料。构建过程包括语言、质量与内容过滤,去重,多来源混合以及词元化。
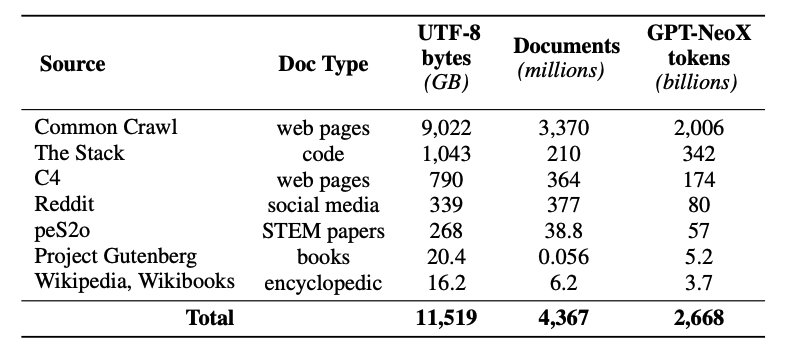
模型训练使用从 Dolma 中抽取的 2 万亿词元。每篇文档末尾加上特殊 EOS 词元后连接起来,按连续的 2,048 词元片段组成训练样本,并打乱顺序。
更多训练细节和硬件规格见论文。
评估结果
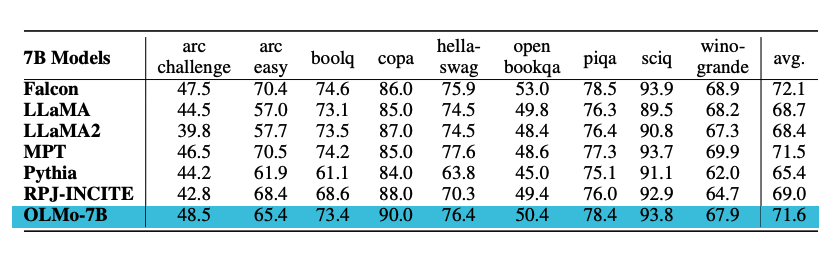
研究者使用 Catwalk 在下游任务上评估,并与 Falcon、Llama 2 等公开模型比较。任务重点衡量常识推理能力,包括 piqa 和 hellaswag。
评估采用零样本排序分类:按照补全内容的似然排序,并报告准确率。OLMo-7B 在两个任务中超过所有对比模型,在九个任务中的八个保持前三。
OLMo 提示词指南
上游原文此部分标为“即将更新”,尚未提供正文。
图片来源:OLMo:促进语言模型科学研究。