
外观
上下文工程指南
目录
什么是上下文工程?
几年前,很多人,甚至一些顶尖 AI 研究者,认为提示工程到现在就会消失。
作者认为,事实恰恰相反:提示工程变得更加重要,以至于人们开始用“上下文工程”这个名称来描述它。这个新术语强调的,仍然是调整指令与相关背景信息,使模型有效完成任务。
Ankur Goyal、Walden Yan、Tobi Lutke 和 Andrej Karpathy 都讨论过这一主题。本文结合作者的理解,逐步展示如何在 AI 智能体工作流中实践上下文工程。
作者不确定谁最先提出这一名称,下面借用 Dex Horthy 的图示说明其含义。
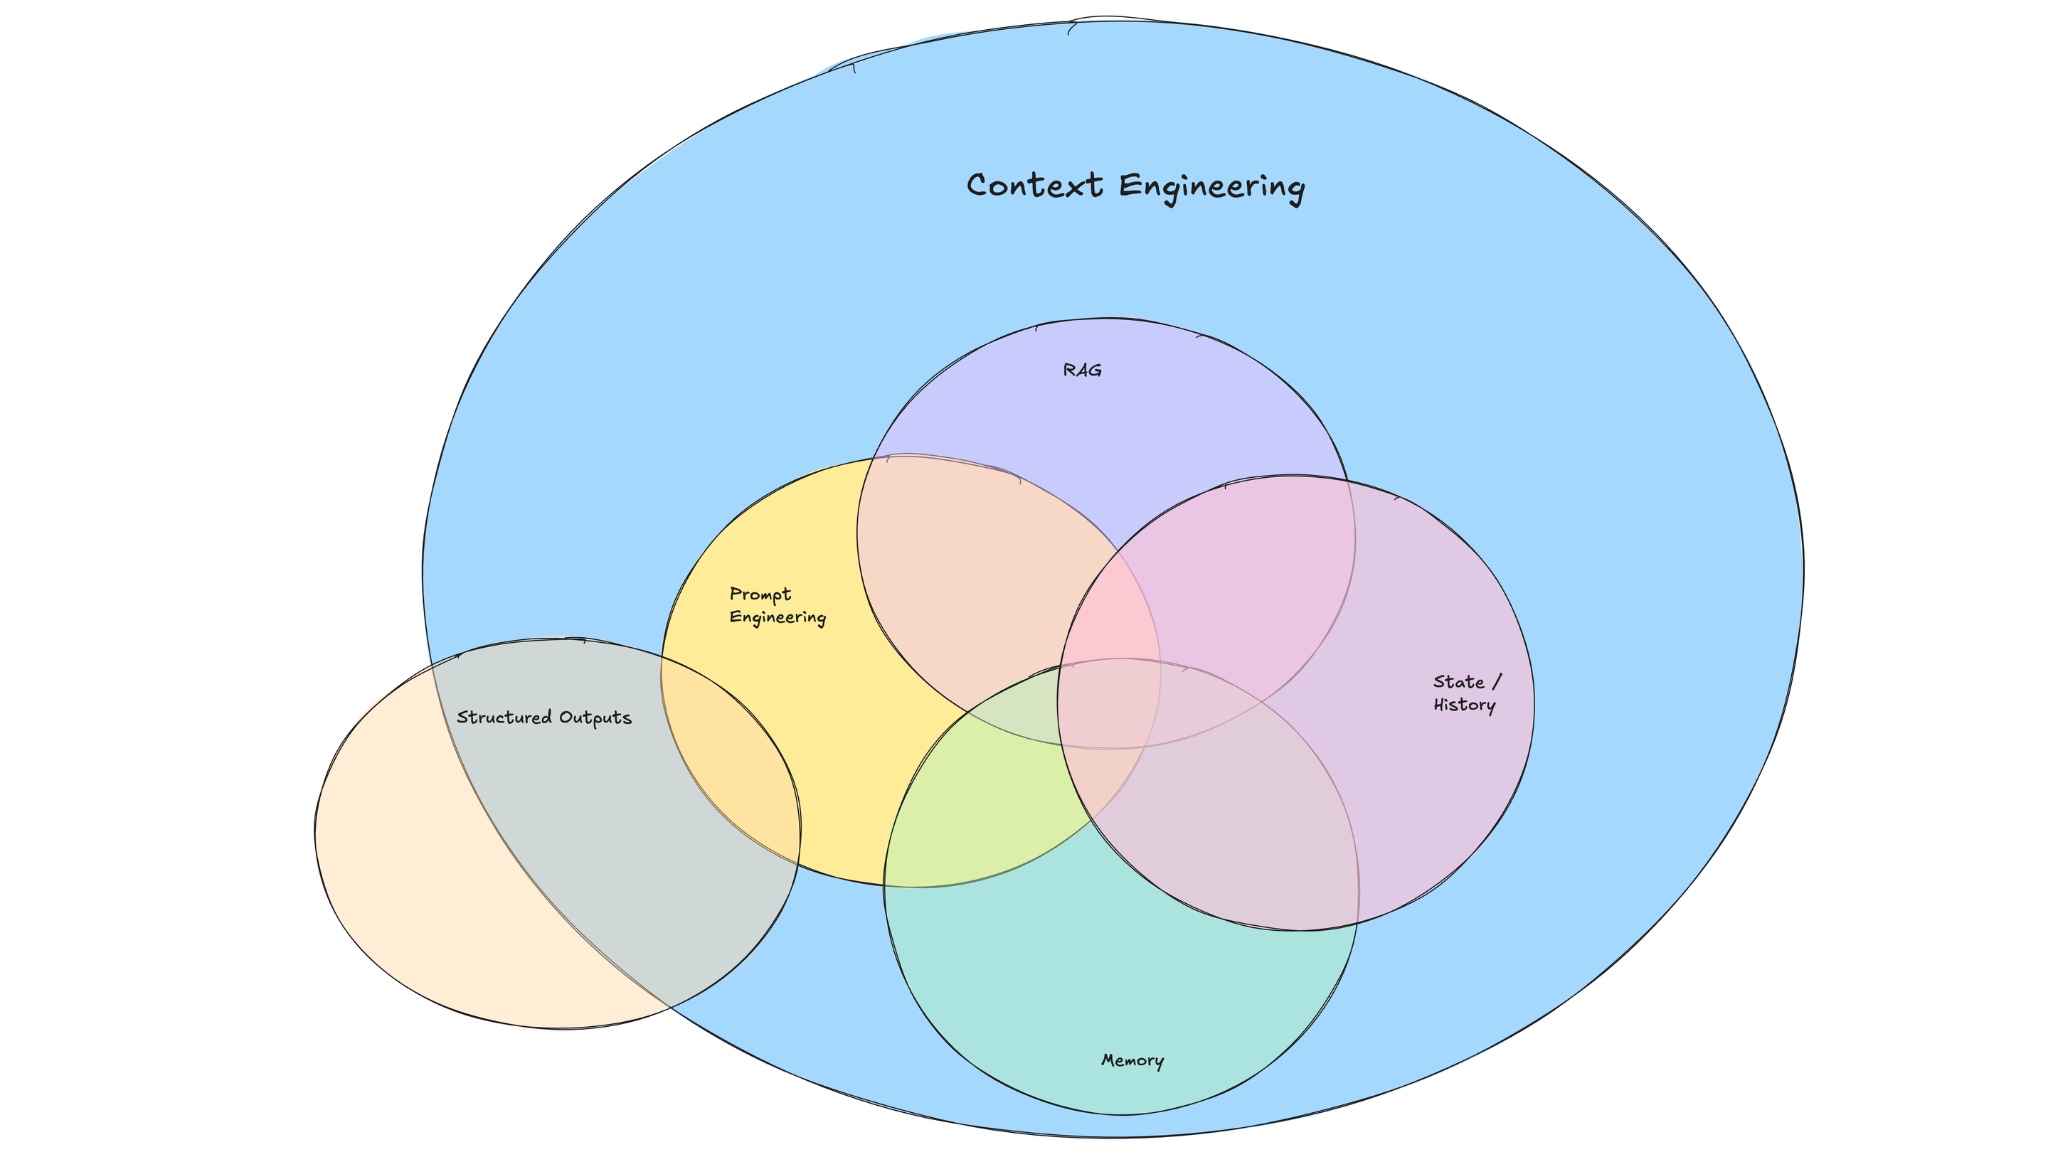
作者喜欢“上下文工程”这个更宽泛的术语,因为它能覆盖提示工程中的多数工作,以及相关的其他任务。
人们怀疑提示工程是不是一项真正的技能,往往是因为把它与随意提问混为一谈。随意提问只是向 ChatGPT 一类系统输入简短任务,而提示工程需要认真考虑上下文和提示词结构。从这个意义上说,也许一开始就该叫上下文工程。
上下文工程进一步关注完整上下文的设计:不只是编写提示词,还要通过更严谨的方法,为系统获取、增强和优化知识。
从开发者角度,它是反复优化模型指令及上下文、以实现目标结果的过程,还包括用评估流程等正式机制判断方法是否有效。
考虑到 AI 的快速发展,作者给出一个更广泛的定义:**设计和优化指令及相关上下文,使大语言模型和先进 AI 模型有效完成任务的过程。**它既适用于文本模型,也适用于日益普及的多模态模型。
相关工作包括:
- 设计与管理提示链。
- 调整指令和系统提示词。
- 管理用户输入、日期时间等动态元素。
- 搜索并准备相关知识,即 RAG。
- 增强查询。
- 定义工具及其使用说明。
- 准备和优化少样本示例。
- 组织输入输出,例如分隔符和 JSON Schema。
- 管理短期记忆中的状态与历史上下文,以及从向量存储检索的长期记忆。
- 其他有助于系统完成目标任务的提示词优化方法。
换言之,上下文工程就是优化提供给模型上下文窗口的信息,包括过滤噪声。这也需要系统地测量模型表现。
下面不再只讨论术语,而是通过智能体构建的具体案例说明它的实际形态。
上下文工程实战
作者为个人使用构建了一个多智能体深度研究应用,在 n8n 中实现工作流。工具本身并非重点,完整架构如下:
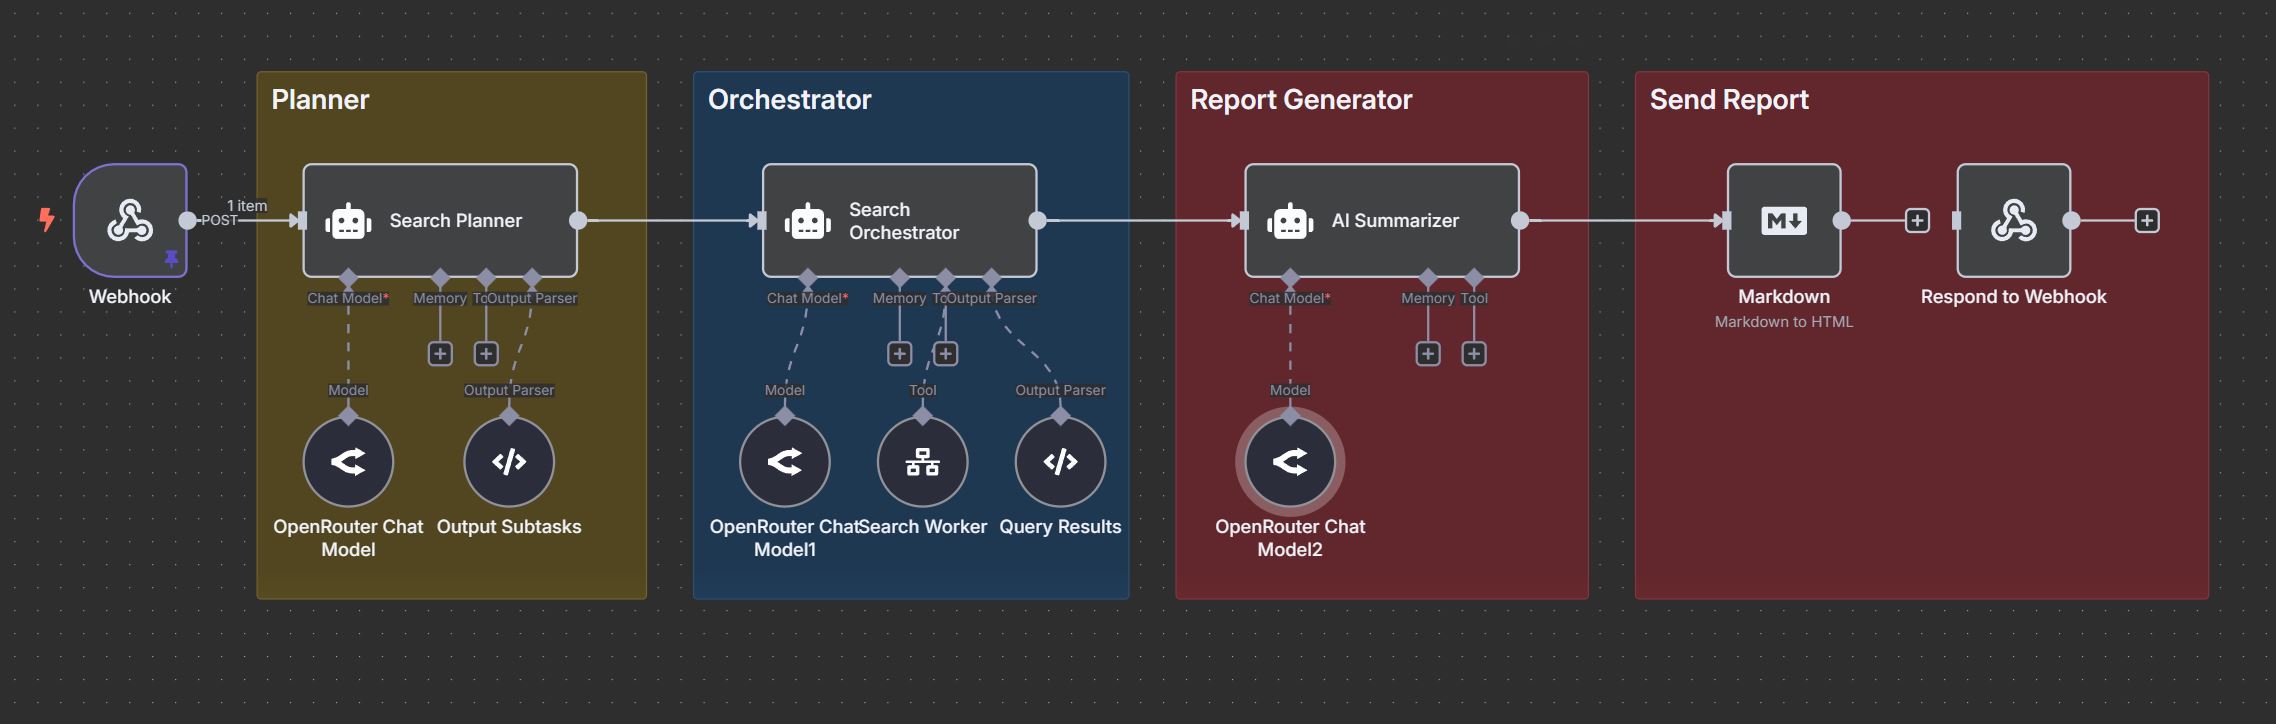
其中,“Search Planner”搜索规划智能体负责根据用户查询生成搜索计划。
系统提示词
下面是这个子智能体的完整系统提示词:
You are an expert research planner. Your task is to break down a complex research query (delimited by <user_query></user_query>) into specific search subtasks, each focusing on a different aspect or source type.

The current date and time is: {{ $now.toISO() }}

For each subtask, provide:
1. A unique string ID for the subtask (e.g., 'subtask_1', 'news_update')
2. A specific search query that focuses on one aspect of the main query
3. The source type to search (web, news, academic, specialized)
4. Time period relevance (today, last week, recent, past_year, all_time)
5. Domain focus if applicable (technology, science, health, etc.)
6. Priority level (1-highest to 5-lowest)

All fields (id, query, source_type, time_period, domain_focus, priority) are required for each subtask, except time_period and domain_focus which can be null if not applicable.

Create 2 subtasks that together will provide comprehensive coverage of the topic. Focus on different aspects, perspectives, or sources of information.

Each substask will include the following information:

id: str
query: str
source_type: str  # e.g., "web", "news", "academic", "specialized"
time_period: Optional[str] = None  # e.g., "today", "last week", "recent", "past_year", "all_time"
domain_focus: Optional[str] = None  # e.g., "technology", "science", "health"
priority: int  # 1 (highest) to 5 (lowest)

After obtaining the above subtasks information, you will add two extra fields. Those correspond to start_date and end_date. Infer this information given the current date and the time_period selected. start_date and end_date should use the format as in the example below:

"start_date": "2024-06-03T06:00:00.000Z",
"end_date": "2024-06-11T05:59:59.999Z",
其中很多部分都需要认真考虑:为了有效完成任务,究竟应该向规划智能体提供什么信息?这不是简单写一句指令,而是通过实验,提供有助于模型表现的必要上下文。
下面逐一分析关键组成。
指令
总体指令明确告诉系统应该做什么:
You are an expert research planner. Your task is to break down a complex research query (delimited by <user_query></user_query>) into specific search subtasks, each focusing on a different aspect or source type.很多初学者,甚至有经验的开发者,可能会到此为止。但完整提示词展示了,要让系统按预期工作,还需要更多上下文。这就是上下文工程:让系统知道问题范围,以及我们究竟希望它产出什么。
用户输入
用户输入没有写在前面的系统提示词里,其形式可以如下:
<user_query> What's the latest dev news from OpenAI? </user_query>这里使用分隔符组织内容,明确哪些是用户输入、哪些是系统需要生成的结果,避免混淆。输入与输出有时很相似,例如输入是查询,输出是子查询,因此结构更重要。
结构化输入与输出
除了总体指令和用户输入,作者还仔细定义了规划智能体需要生成的子任务:
For each subtask, provide:
1. A unique string ID for the subtask (e.g., 'subtask_1', 'news_update')
2. A specific search query that focuses on one aspect of the main query
3. The source type to search (web, news, academic, specialized)
4. Time period relevance (today, last week, recent, past_year, all_time)
5. Domain focus if applicable (technology, science, health, etc.)
6. Priority level (1-highest to 5-lowest)

All fields (id, query, source_type, time_period, domain_focus, priority) are required for each subtask, except time_period and domain_focus which can be null if not applicable.

Create 2 subtasks that together will provide comprehensive coverage of the topic. Focus on different aspects, perspectives, or sources of information.
指令以列表规定所需信息,并提供提示和示例,帮助控制生成结果。例如,不明确指定优先级采用 1 至 5,系统可能自行使用 1 至 10。这样的上下文会显著影响结果。
为了获得一致输出,还要说明子任务格式和字段类型。下面的示例为智能体提供输出预期:
Each substask will include the following information:

id: str
query: str
source_type: str  # e.g., "web", "news", "academic", "specialized"
time_period: Optional[str] = None  # e.g., "today", "last week", "recent", "past_year", "all_time"
domain_focus: Optional[str] = None  # e.g., "technology", "science", "health"
priority: int  # 1 (highest) to 5 (lowest)
在 n8n 中,还可以使用工具输出解析器组织最终结果。作者选择提供如下 JSON 示例:
{
  "subtasks": [
    {
      "id": "openai_latest_news",
      "query": "latest OpenAI announcements and news",
      "source_type": "news",
      "time_period": "recent",
      "domain_focus": "technology",
      "priority": 1,
      "start_date": "2025-06-03T06:00:00.000Z",
      "end_date": "2025-06-11T05:59:59.999Z"
    },
    {
      "id": "openai_official_blog",
      "query": "OpenAI official blog recent posts",
      "source_type": "web",
      "time_period": "recent",
      "domain_focus": "technology",
      "priority": 2,
      "start_date": "2025-06-03T06:00:00.000Z",
      "end_date": "2025-06-11T05:59:59.999Z"
    },
...
}
工具据此自动生成 Schema,让系统解析并产生正确的结构化输出:
[
  {
    "action": "parse",
    "response": {
      "output": {
        "subtasks": [
          {
            "id": "subtask_1",
            "query": "OpenAI recent announcements OR news OR updates",
            "source_type": "news",
            "time_period": "recent",
            "domain_focus": "technology",
            "priority": 1,
            "start_date": "2025-06-24T16:35:26.901Z",
            "end_date": "2025-07-01T16:35:26.901Z"
          },
          {
            "id": "subtask_2",
            "query": "OpenAI official blog OR press releases",
            "source_type": "web",
            "time_period": "recent",
            "domain_focus": "technology",
            "priority": 1.2,
            "start_date": "2025-06-24T16:35:26.901Z",
            "end_date": "2025-07-01T16:35:26.901Z"
          }
        ]
      }
    }
  }
]
这看起来复杂,但很多工具已经内置结构化输出能力,未必需要自己实现。n8n 让这部分工作较为简单。作者认为,很多开发者低估了结构化输出的价值,尤其当智能体结果不稳定,却又必须按特定格式传给下一个工作流组件时,它非常有用。
工具
使用 n8n 时,可以通过如下方式把当前日期和时间加入上下文:
The current date and time is: {{ $now.toISO() }}这是一个简单的内置函数,也可以做成专门工具,只在查询需要时获取日期时间。上下文工程要求开发者明确决定:传递什么信息,以及何时传递。这有助于减少应用中的假设和误差。
日期时间对研究系统很重要。如果要求搜索“OpenAI 上周的最新开发者新闻”,却不给当前日期,模型可能猜测时间,生成不准确的查询。正确日期能帮助推断时间范围,而搜索智能体和工具需要这些范围。
作者加入了以下指令,让模型生成日期区间:
After obtaining the above subtasks information, you will add two extra fields. Those correspond to start_date and end_date. Infer this information given the current date and the time_period selected. start_date and end_date should use the format as in the example below:

"start_date": "2024-06-03T06:00:00.000Z",
"end_date": "2024-06-11T05:59:59.999Z",
这里重点讨论规划智能体,因此所需工具不多。另一个可能有用的工具,是根据查询检索相关子任务。
RAG 与记忆
这个深度研究应用的第一版不需要短期记忆,但作者也构建了缓存不同用户查询及其子查询的版本,以加速和优化流程。
如果先前处理过相似查询,可以把结果保存在向量存储中,后续检索已有计划,避免再次生成同一组子查询。每次模型 API 调用都会增加延迟和费用,复用已有结果可以降低这些成本。
这说明上下文工程不只是优化提示词,还要根据目标选择合适的信息。如何维护向量存储、如何把既有子任务引入上下文,都有发挥创造性的空间。作者认为,有创意的上下文工程可以成为产品优势。
状态与历史上下文
虽然第一版没有展示,但这个项目的重要部分是优化中间结果,生成最终报告。系统可能需要修改全部或部分查询、子任务,以及搜索 API 返回的数据。
这意味着系统会多次尝试解决问题,需要访问先前状态,甚至完整的相关历史。对于本例,可包括子任务状态、修订记录、各个智能体先前的结果,以及修改阶段所需的其他背景。
具体传递哪些内容,取决于优化目标,需要作出很多设计决策,也需要多次迭代。因此评估尤其重要:如果不测量这些行为,就无法知道上下文工程是否真正有效。
进阶上下文工程
本文尚未详细讨论上下文压缩、管理技术、安全,以及上下文有效性评估等主题。原作者计划在后续文章继续介绍。
上下文可能被稀释,或被过时、无关信息填满,降低效率,需要专门的评估流程识别这些问题。
作者预计,上下文工程会继续成为 AI 开发者的重要技能。除手动调整外,还可以探索自动化处理方法。已有一些工具尝试这样做,但这一方向仍需要进步。
原文课程信息
本文基于《使用 n8n 构建有效的 AI 智能体》,提供实现方法、模板、提示词和进阶技巧。原文提供 PROMPTING20 优惠码,可享 Pro 会员八折,当前有效性以课程方说明为准。